이미지에서 색상 추출하기
“이미지에서 색상을 뽑아낼 수 있으면 편하겠다. 그리고 그 이미지의 키 컬러를 뽑아내면 좋겠다.”라는 생각으로 시작했어요. 제가 살펴본 도구는 특정 픽셀을 찍거나 색을 너무 많이 나열해서, 원하는 팔레트를 얻기가 아쉬웠습니다. 그래서 Image Colors를 만들었습니다.
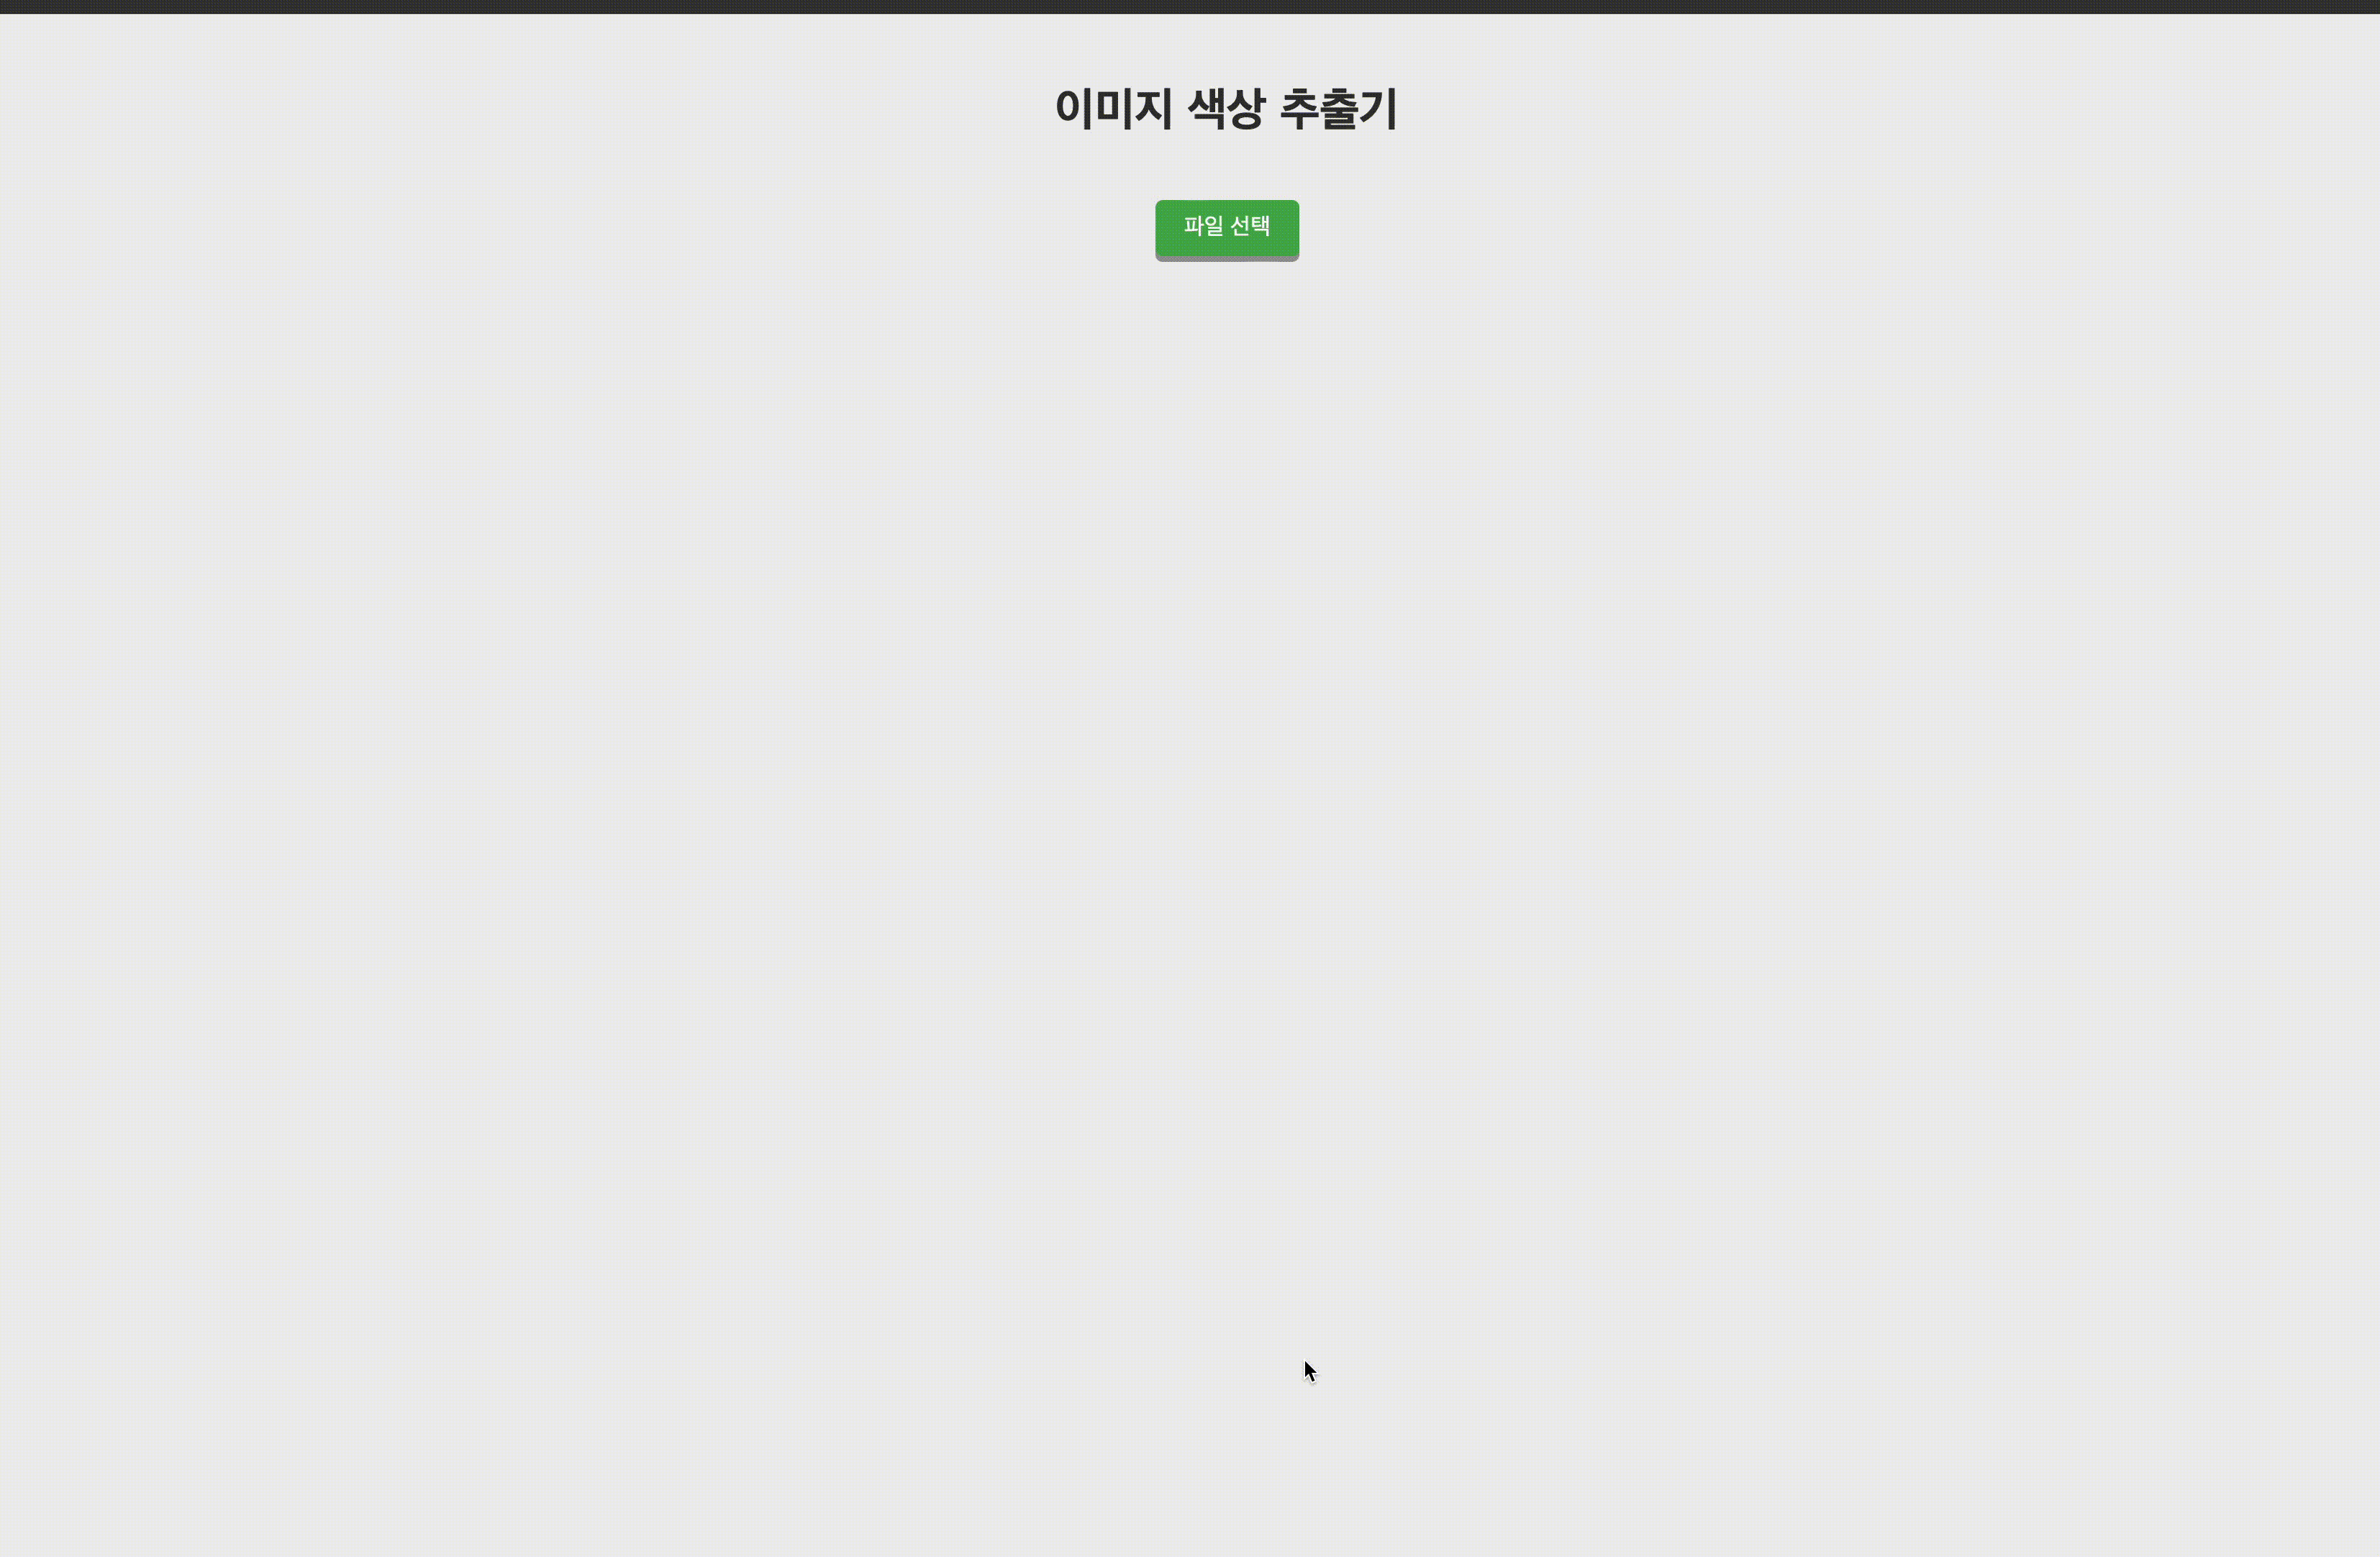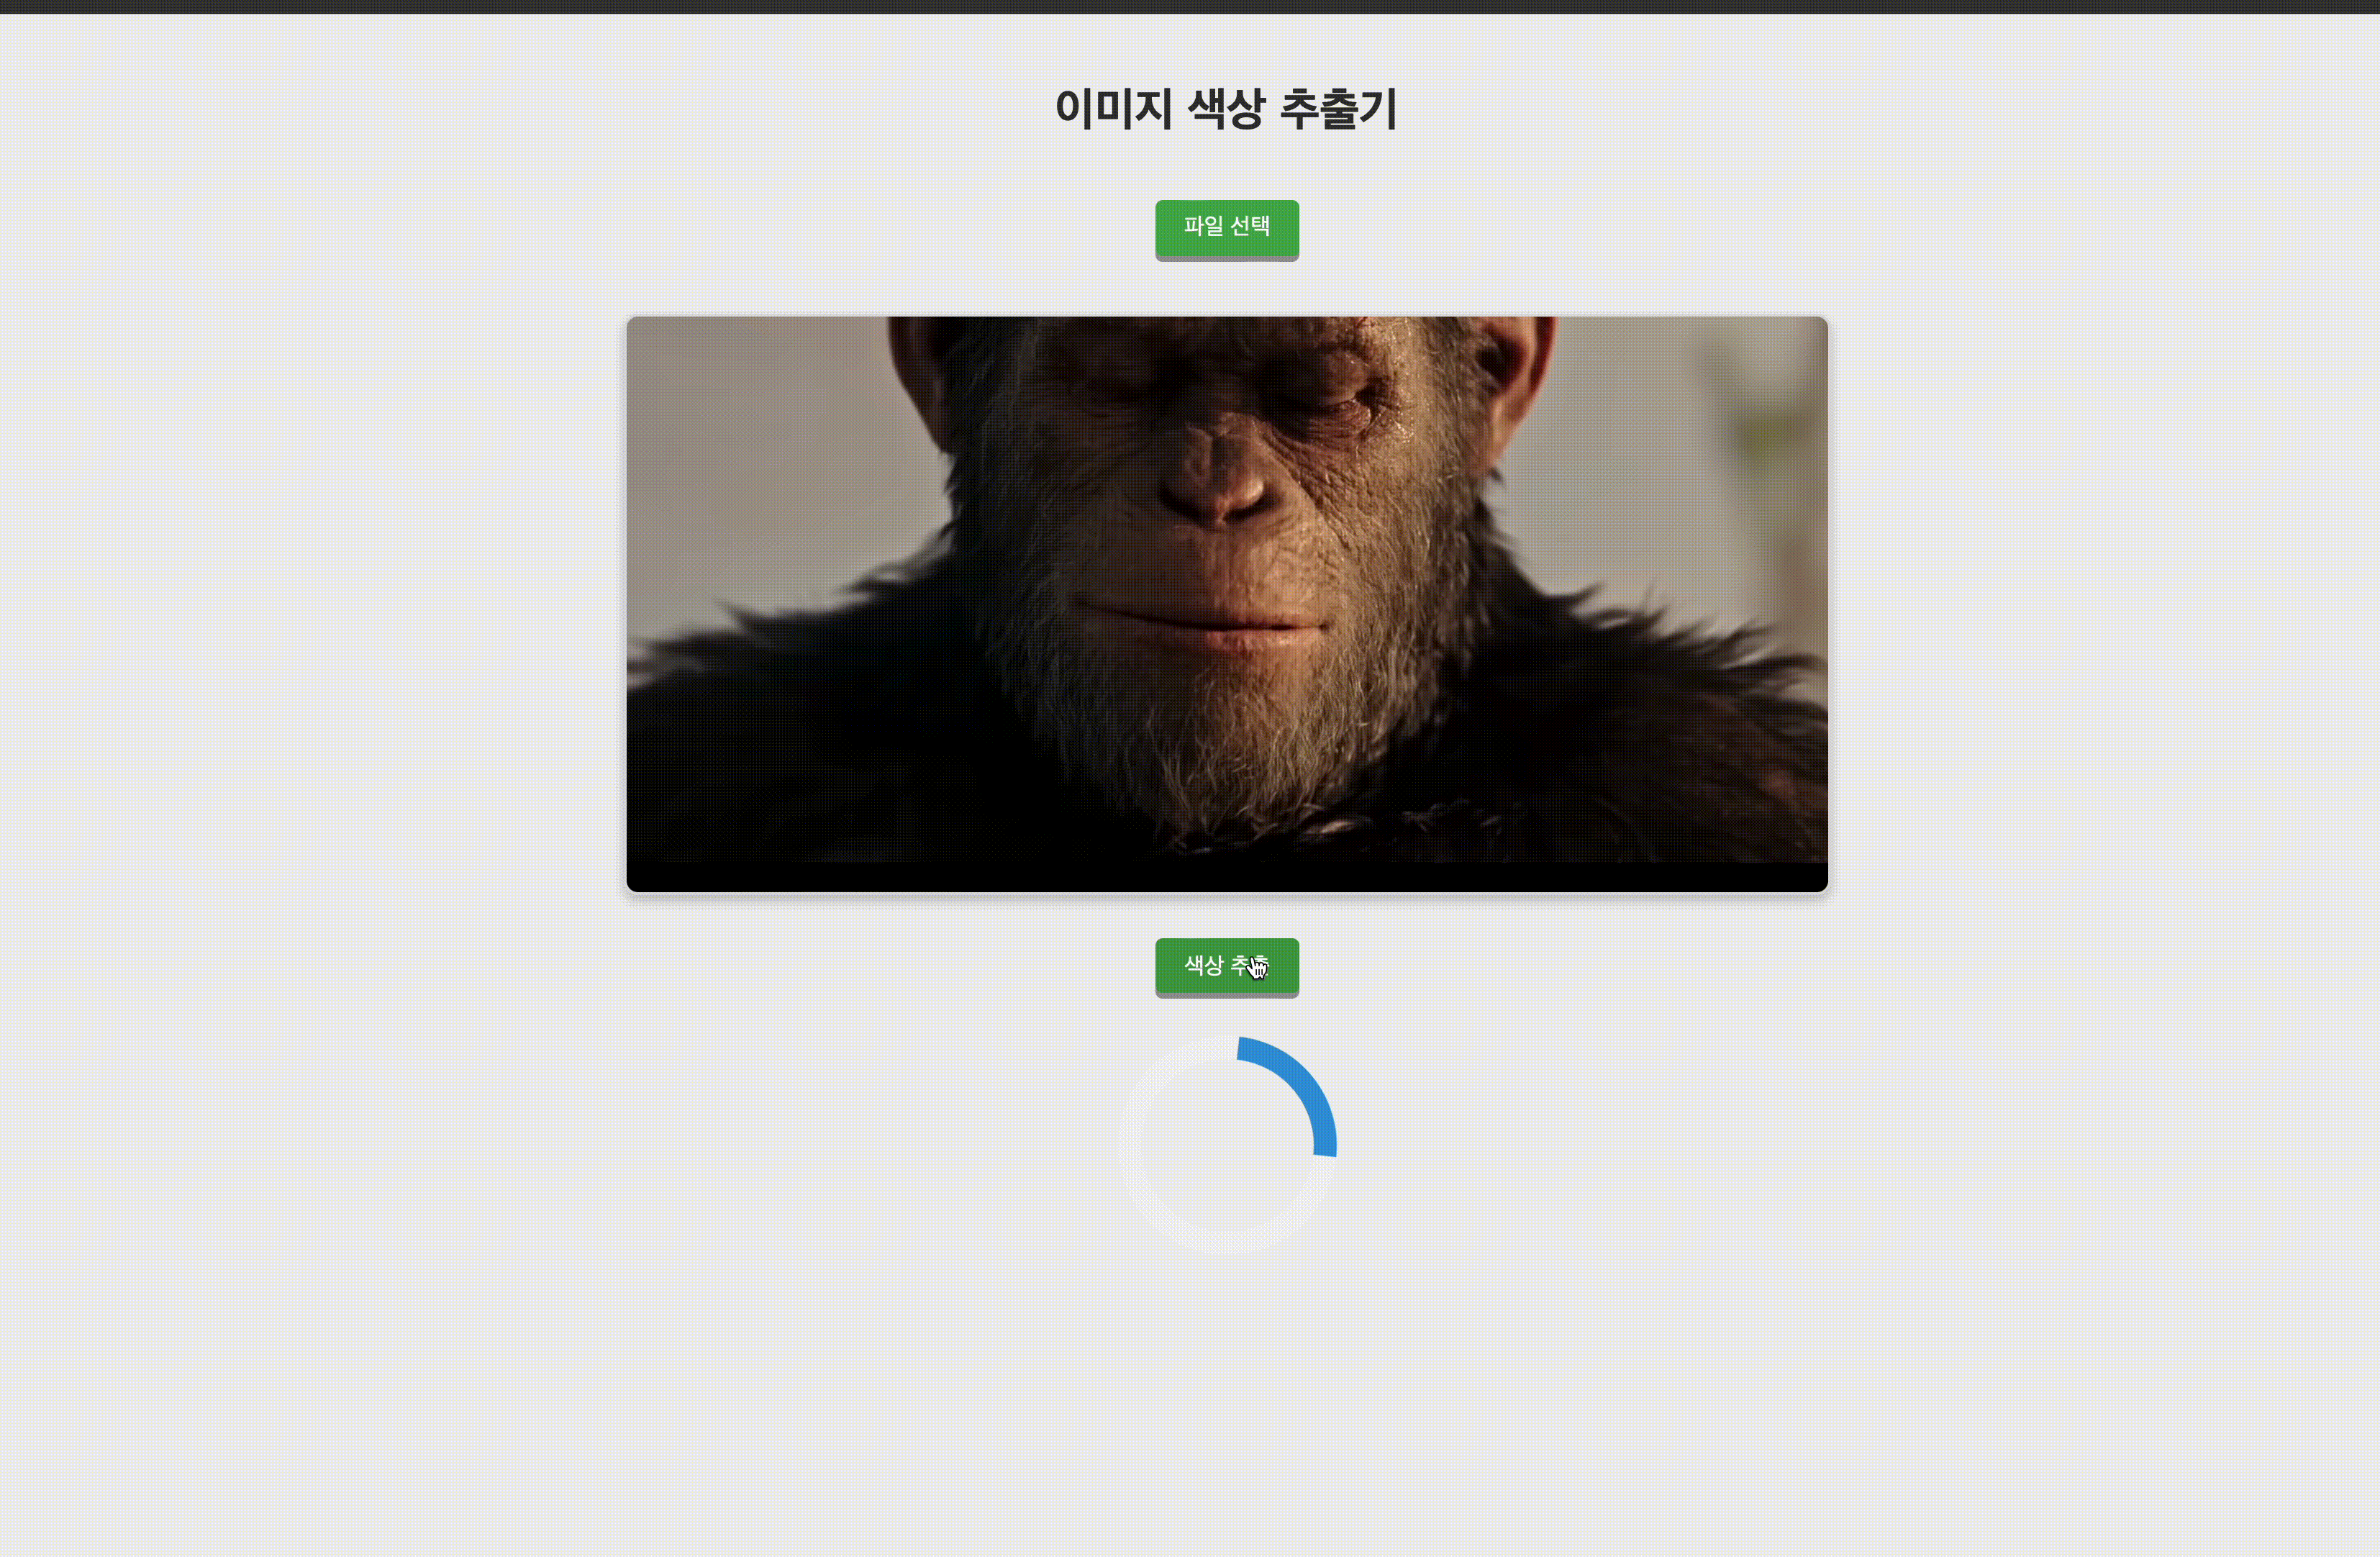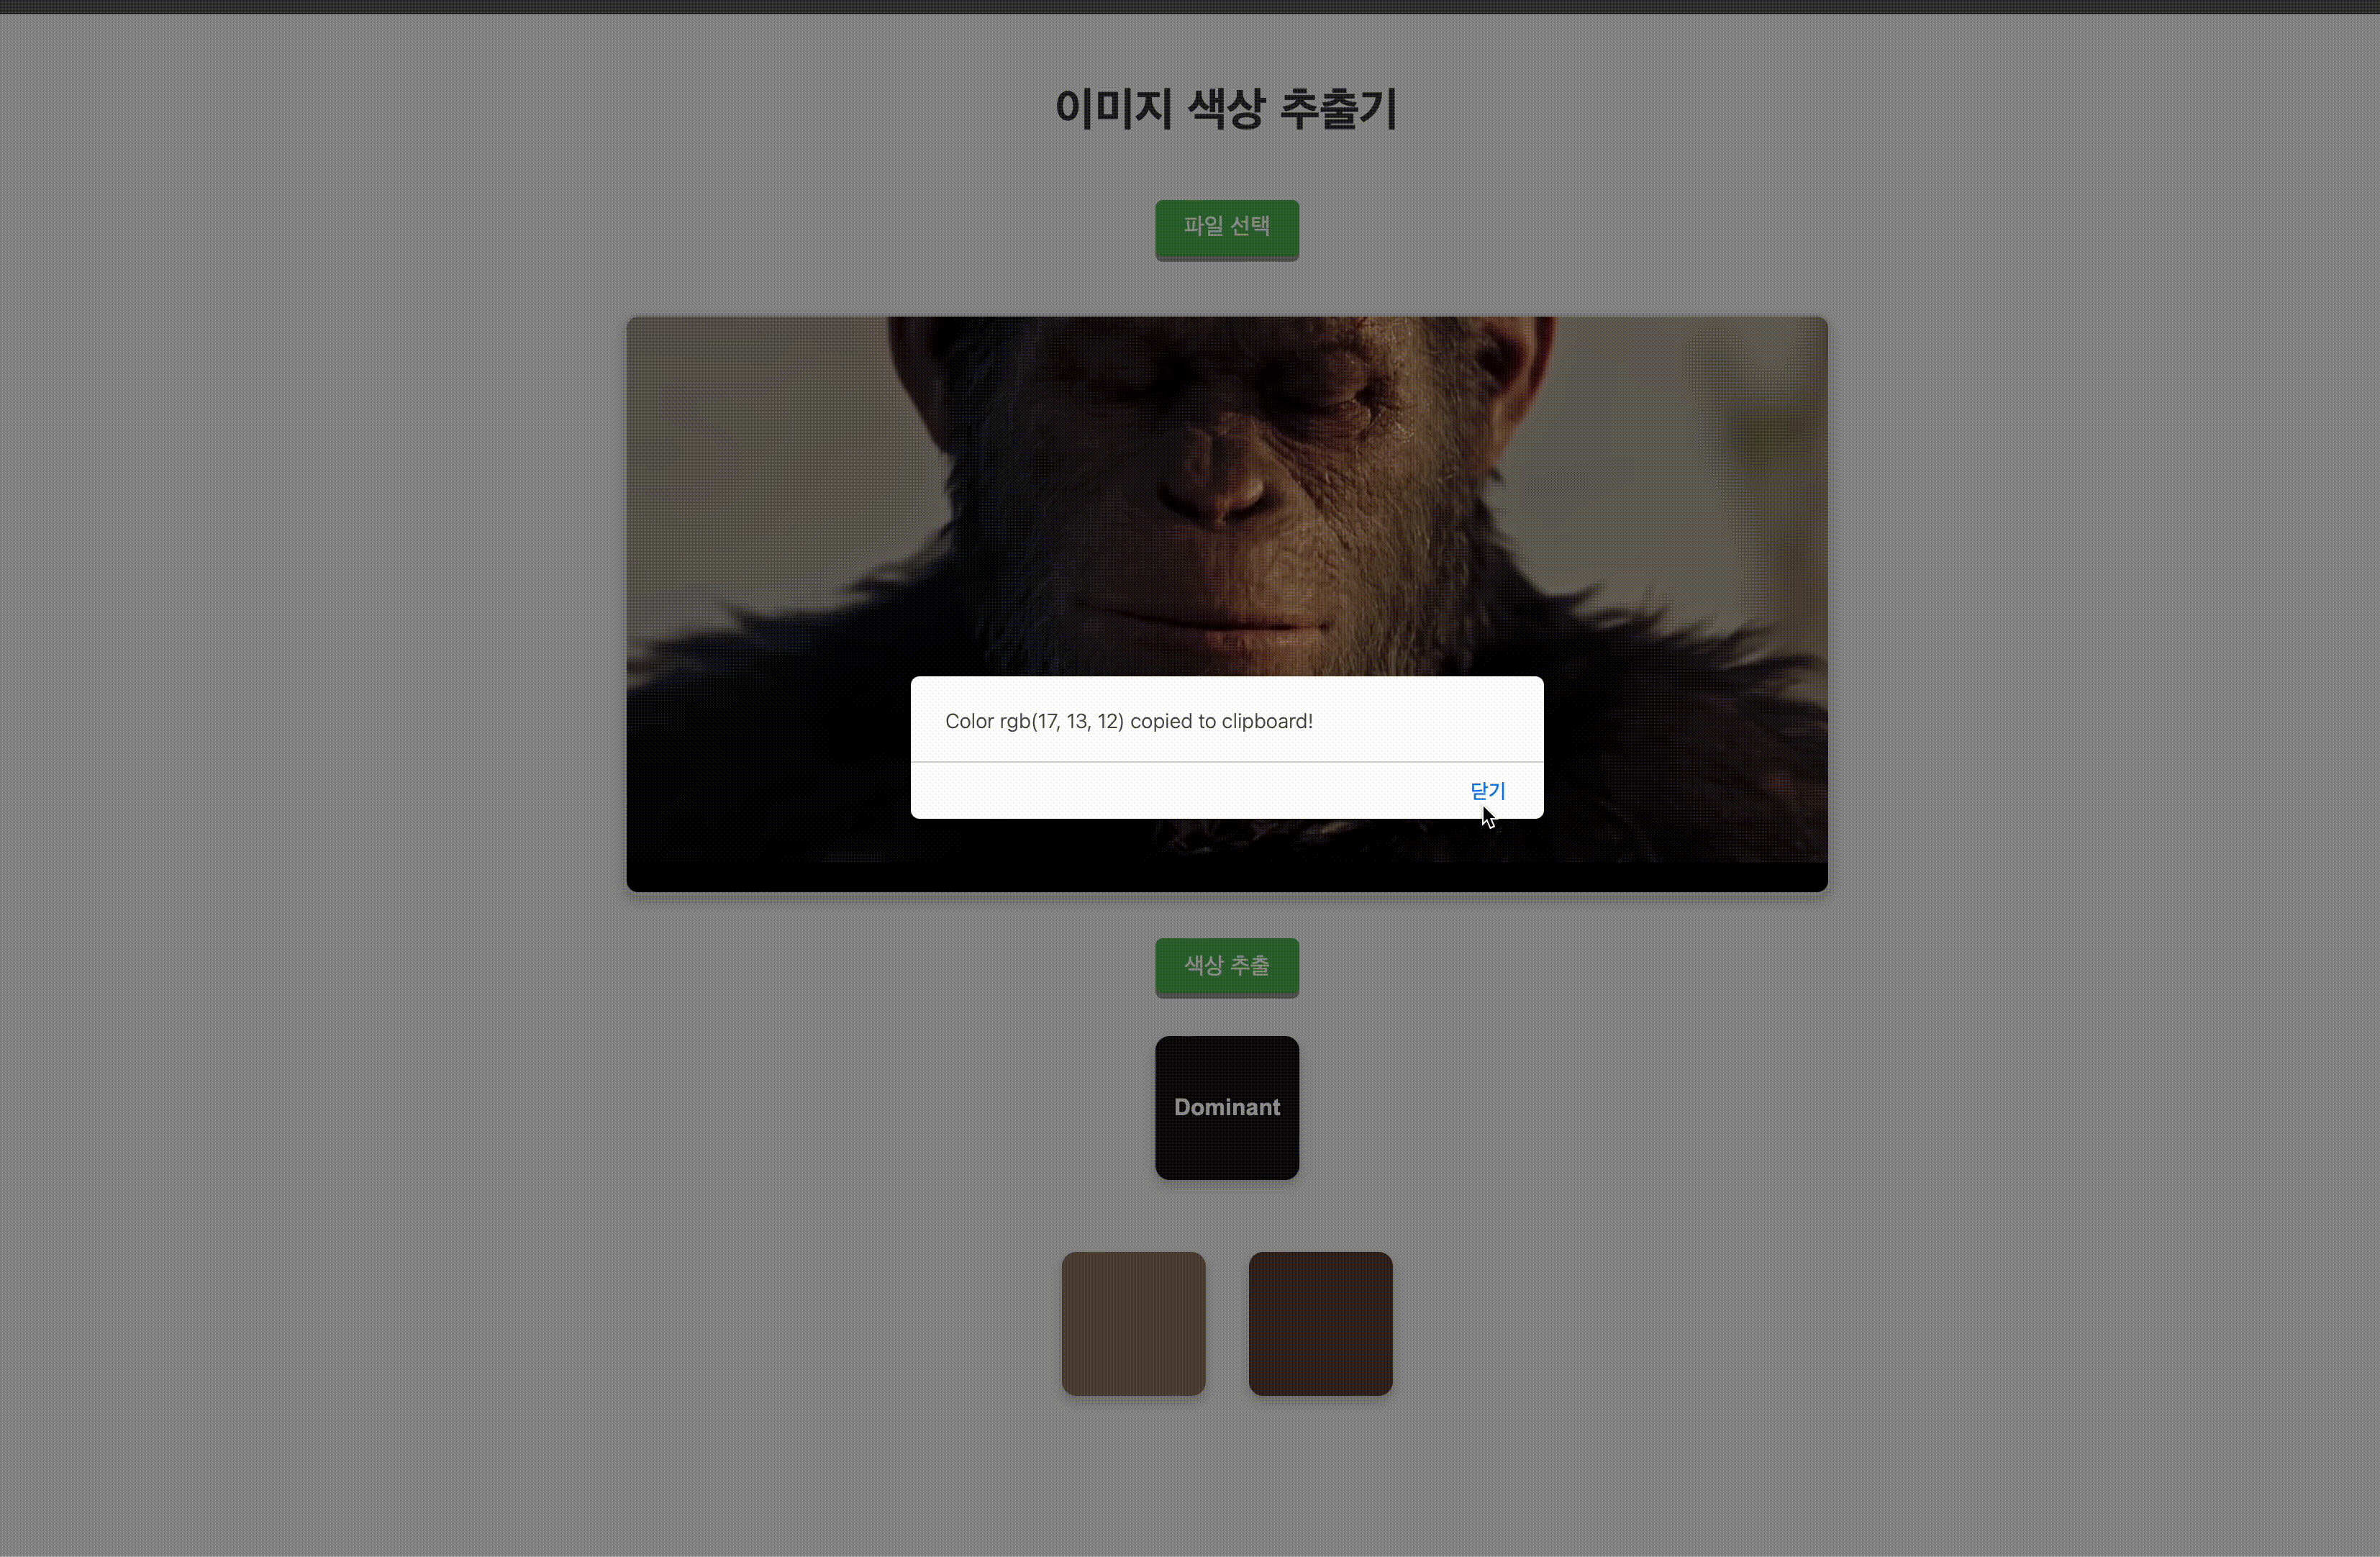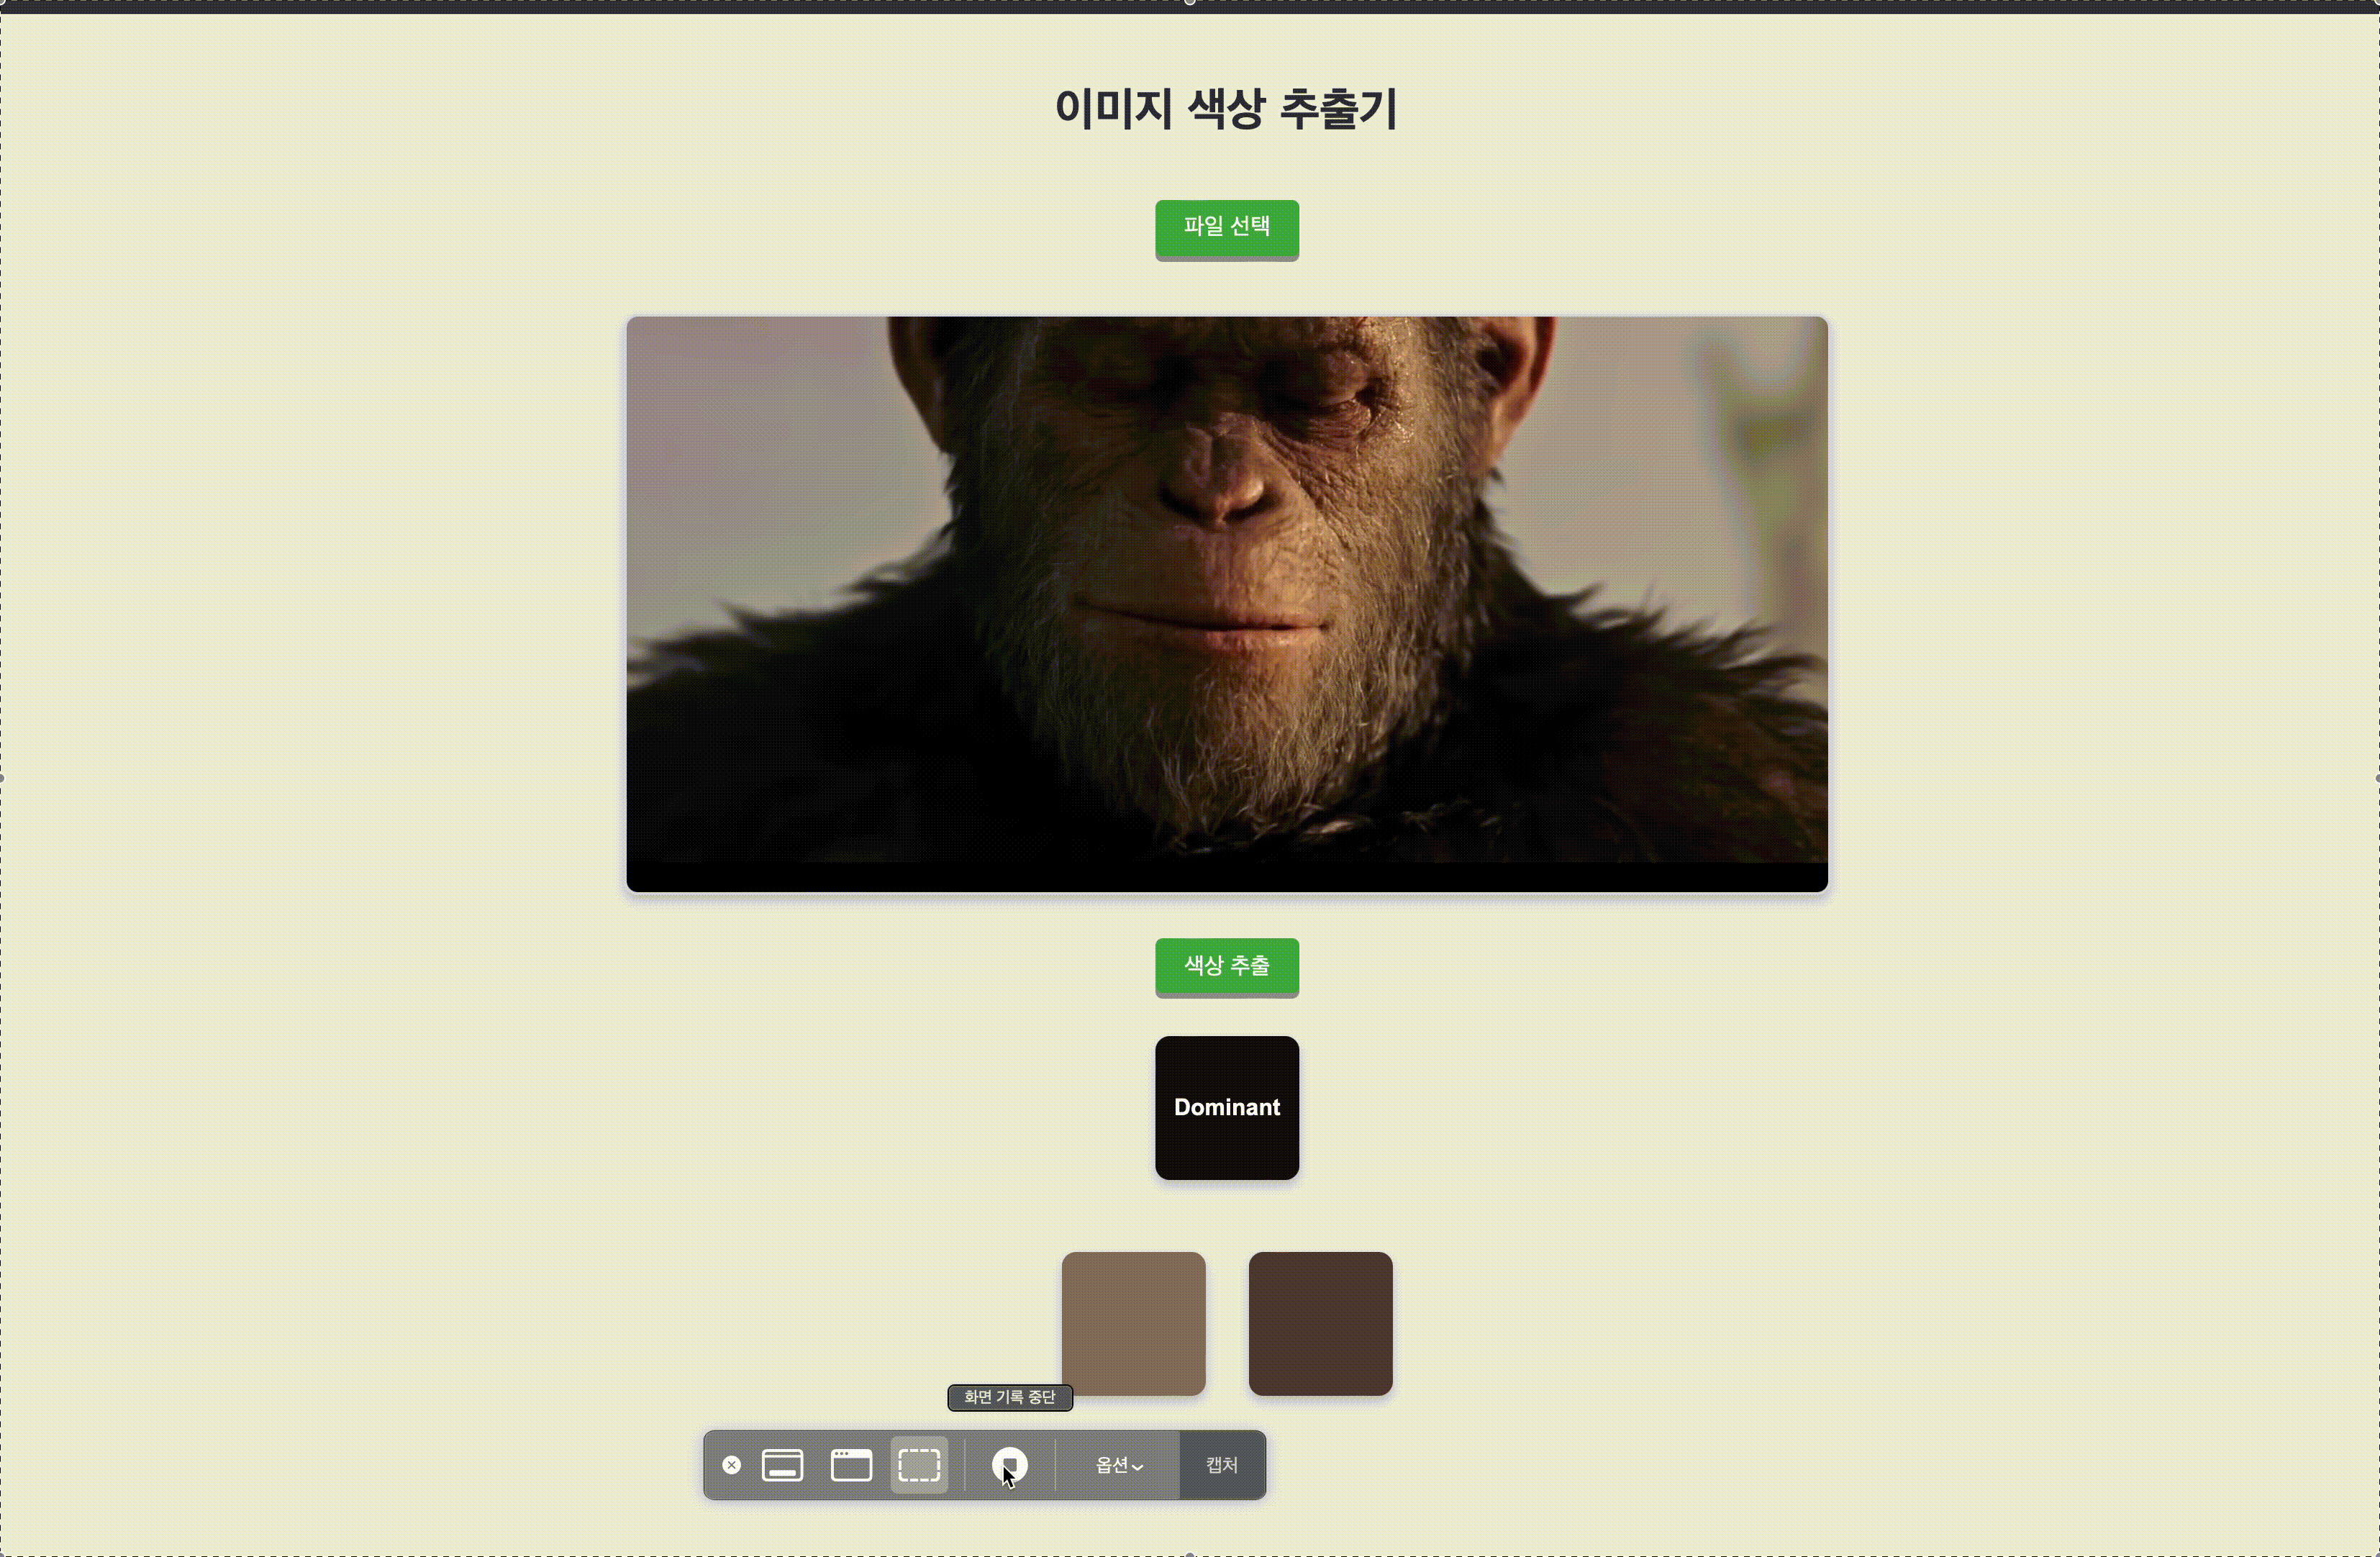 Image Colors 라이브러리 동작 데모
먼저 구분할 점은 가장 많이 등장하는 색과 화면에 쓰기 좋은 색은 다르다는 것입니다. 아래는 당시 개발 과정을 돌아보고 설계 기준을 보충한 글이에요. 코드는 원리를 설명하는 독립 예시이며, 배포 패키지의 실제 API와 같다고 가정하면 안 됩니다.
먼저 어떤 색을 뽑을지 정하기
흰 배경에 빨간 사과가 있는 사진을 생각해봅시다. 면적만 세면 흰색이 대표색이 될 수 있지만, 상품 카드의 강조색으로는 빨간색을 원할 수 있어요.
| 원하는 결과 | 우선할 기준 | 놓칠 수 있는 것 |
|---|---|---|
| 이미지의 전체 분위기 | 색 군집의 픽셀 비중 | 작은 피사체의 강조색 |
| UI에 쓸 강조색 | 비중에 채도·명도 등의 조건 추가 | 원본의 면적 비율 |
| 원본에 실제 존재하는 색 | 군집 중심에 가까운 원본 픽셀 선택 | 수학적인 평균색 |
따라서 군집화로 후보를 찾는 일과 그 후보를 정렬하는 일을 분리하는 편이 좋습니다. “대표색”이라는 이름 하나에 서로 다른 목적을 숨기면, 알고리즘을 바꿔도 결과가 마음에 들지 않을 수 있어요.
성능: 픽셀 수와 전체 처리 시간을 구분하기
처음에는 모든 픽셀을 분석했는데, 4K 이미지 한 장은 3840 × 2160 = 8,294,400픽셀입니다. 8비트 RGBA 배열만 계산해도 픽셀 수 × 4바이트, 약 31.6MiB예요. 디코딩된 이미지와 Canvas 등의 메모리는 별도입니다.
당시에는 일부 픽셀을 샘플링해 군집화 입력을 줄였습니다. 가로·세로를 각각 10픽셀 간격으로 읽으면 이 크기에서는 82,944개, 전체의 1/100입니다. 다만 이미지를 디코딩하고 전체 ImageData를 읽은 뒤라면 그 비용까지 1/100로 줄어드는 것은 아니에요.
아래 예시는 이미 읽은 8비트 RGBA 버퍼에서 표본을 고르는 부분만 보여줍니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
type RGB = readonly [number, number, number];

interface PixelBuffer {
  width: number;
  height: number;
  data: Uint8ClampedArray; // RGBA 순서, 픽셀당 4바이트
}

function sampleColors(image: PixelBuffer, step = 10): RGB[] {
  const { width, height, data } = image;
  if (!Number.isInteger(step) || step < 1) {
    throw new RangeError('step은 1 이상의 정수여야 합니다.');
  }
  if (!Number.isInteger(width) || !Number.isInteger(height) ||
      width < 1 || height < 1 || data.length !== width * height * 4) {
    throw new RangeError('RGBA 버퍼와 이미지 크기가 일치하지 않습니다.');
  }

  const colors: RGB[] = [];
  for (let y = 0; y < height; y += step) {
    for (let x = 0; x < width; x += step) {
      const i = (y * width + x) * 4;
      if (data[i + 3] === 0) continue; // 완전 투명한 픽셀 제외
      colors.push([data[i], data[i + 1], data[i + 2]]);
    }
  }
  return colors;
}
격자 샘플링은 단순하고 재현하기 쉽지만 얇은 선이나 반복 무늬를 놓칠 수 있습니다. 축소한 이미지로 분석하면 픽셀 읽기 비용도 줄일 수 있지만, 보간으로 원본에 없던 혼합색이 생길 수 있어요. 따라서 “샘플링 비율”만 비교하지 말고, 작은 강조색을 얼마나 보존하는지도 같이 확인해야 합니다.
브라우저와 Node.js 사이의 경계
두 환경을 지원하려고 어댑터 패턴을 사용했습니다. 브라우저에서는 이미지와 Canvas를, Node.js에서는 Sharp나 Jimp 같은 디코더를 이용할 수 있습니다. 코어에는 DOM의 ImageData 자체보다 위 예시처럼 너비·높이·RGBA 버퍼라는 계약을 넘기면 환경별 의존성을 좁힐 수 있어요.
브라우저에서는 다음 조건을 별도로 처리해야 합니다.
- 이미지 디코딩 실패와 크기가 0인 입력
- Canvas 2D 컨텍스트 생성 실패
- 외부 이미지의 CORS 허용 여부
crossOrigin = 'anonymous'는 서버의 접근 허용을 대신하지 않습니다. 허용되지 않은 외부 이미지로 Canvas가 오염되면 getImageData()는 SecurityError를 던집니다. WHATWG Canvas 명세
투명도와 색 공간도 계약의 일부입니다. 완전 투명한 픽셀은 제외하더라도, 반투명한 픽셀을 원래 RGB로 셀지 배경에 합성한 색으로 셀지는 결정해야 해요. 브라우저와 서버가 서로 다른 배경이나 색 변환을 사용하면 같은 파일에서도 팔레트가 달라질 수 있습니다.
K-means: 재현성과 지각적 유사성은 별개의 문제
K-means는 픽셀을 색 공간의 점으로 보고 K개 군집으로 나눕니다. 표준 K-means는 각 점과 소속 군집 중심 사이의 제곱 유클리드 거리 합을 줄이는 방식입니다. 초기 중심이 달라지면 다른 결과가 나올 수 있어요. scikit-learn KMeans 문서
당시에는 여러 번 실행해 군집 내 오차가 작은 결과를 골랐습니다. 이것은 나쁜 초기값의 영향을 줄이는 방법이고, 실행마다 같은 결과를 보장하는 방법은 아닙니다. 재현성이 목적이라면 표본, 난수 시드, 종료 조건, 동점일 때의 정렬 기준까지 고정해야 합니다.
색 차이를 평가하는 데는 CIEDE2000도 적용했습니다. 여기서 구분할 점이 있어요. CIELAB 좌표로 유클리드 K-means를 하는 것과 CIEDE2000을 거리 함수로 사용하는 것은 같은 알고리즘이 아닙니다. 거리만 바꾸고 중심을 계속 산술평균으로 갱신한다고 기존 목적함수의 성질이 유지되지는 않습니다.
실용적인 설계 예시는 Lab 공간에서 후보를 군집화한 뒤 CIEDE2000으로 너무 비슷한 후보를 합치거나 결과를 비교하는 것입니다. 수식을 직접 구현했다면 연구자가 공개한 테스트 쌍으로 검증할 수 있습니다. Sharma 등의 CIEDE2000 구현 설명과 테스트 데이터
라이브러리의 품질을 어떻게 확인할까
TypeScript로 전환하면서 타입 관련 오류를 더 일찍 발견할 수 있었지만, 타입 검사만으로 잘못된 이미지나 범위를 벗어난 옵션을 막을 수는 없습니다. 예를 들어 K가 유효한 색 개수보다 크거나, 투명 픽셀을 제외하고 나니 입력이 비어 있을 수 있어요. 이런 입력의 반환값과 오류 정책도 API로 정해야 합니다.
다음은 재현 실험을 구성할 때 쓸 수 있는 작은 입력 집합입니다. 측정 결과가 아니라 검증 계획이에요.
| 입력 | 확인할 것 |
|---|---|
| 단색 이미지 | 빈 군집이나 NaN 없이 처리되는가 |
| 면적이 다른 두 색 | 군집 비중이 의도한 정책과 맞는가 |
| 투명 여백이 큰 로고 | 보이지 않는 영역이 대표색이 되지 않는가 |
| 가는 줄무늬·작은 강조색 | 샘플링 간격에 따른 누락은 어느 정도인가 |
| 같은 이미지 반복 실행 | 색과 정렬 순서가 재현되는가 |
| 고해상도 사진 | 디코딩·픽셀 읽기·군집화 중 어디가 느린가 |
처음에는 “색을 몇 개 뽑아준다”가 목표였지만, 좋은 라이브러리는 무슨 기준으로 뽑았는지와 어떤 입력에서 흔들리는지를 설명할 수 있어야 하더라고요. 옵션을 늘리기보다 기본 결과의 의미를 명확히 하고, 실제 병목을 찾은 뒤 필요한 최적화를 더하는 쪽이 유지보수에도 도움이 됩니다.
프로젝트의 원래 저장소 주소는 Image Colors입니다. 이번 보완에서는 해당 저장소 내용을 확인하지 못했으므로, 위 설계 예시를 현재 배포본의 기능 보장으로 읽으면 안 됩니다.