DALL-E 및 사용 후기
DALL-E 2 API로 이미지 생성과 부분 편집을 써봤습니다. 이미지를 만들어주는 기능은 쉽게 연결할 수 있었지만, 원하는 결과를 안정적으로 얻는 제품 흐름까지 준비되는 것은 아니었어요. 이 글은 2023년 4월 당시의 사용 후기와 DALL-E 1·2의 구조를 정리한 기록입니다.
아래 모델, API 기능과 지원 크기는 2023년 기준입니다. 현재 이미지 API 사용법이나 모델 선택 가이드가 아닙니다. 개정하면서 원리를 보완했으며, 당시 생성 결과를 최신 모델로 다시 실험한 것은 아닙니다.
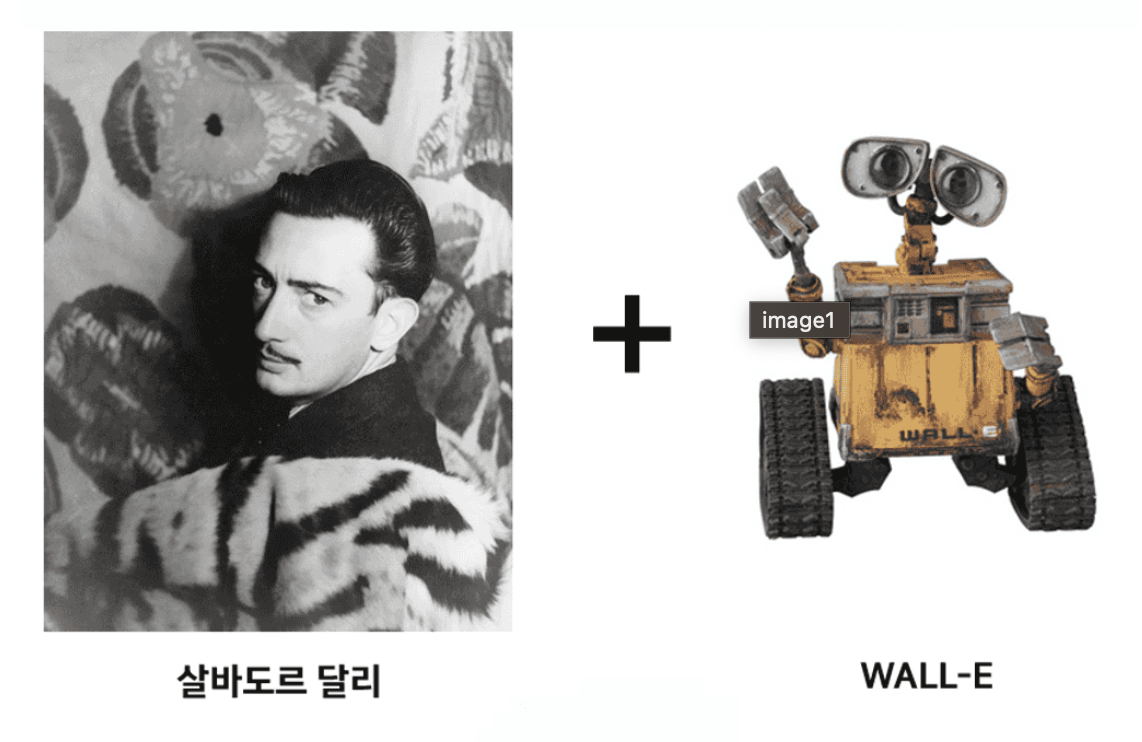 DALL-E
 1과 2는 어떻게 다를까?
둘 다 텍스트에서 이미지를 만들지만 내부의 생성 방식은 다릅니다.
| 구분 | DALL-E 1 | DALL-E 2 |
|---|---|---|
| 중간 표현 | 압축된 이미지 토큰의 시퀀스 | CLIP 이미지 임베딩 |
| 생성의 핵심 | 텍스트 뒤에 이미지 토큰을 차례로 예측 | 텍스트에서 이미지 임베딩을 예측한 뒤 diffusion으로 이미지 생성 |
| 이해할 때의 주의점 | RGB 픽셀 값을 하나씩 직접 예측하는 구조가 아님 | CLIP이 혼자 이미지를 그리는 구조가 아님 |
DALL-E 1: 이미지를 토큰으로 바꿔 예측하기
DALL-E 1은 먼저 discrete VAE(dVAE)로 256×256 이미지를 32×32, 즉 1,024개의 이미지 토큰으로 압축합니다. 이후 Transformer가 텍스트 토큰과 이미지 토큰의 관계를 학습하고, 생성한 이미지 토큰을 디코더가 픽셀로 복원해요.
이미지를 압축하는 모델과 토큰의 다음 위치를 예측하는 모델의 역할을 나누면 이해하기 쉽습니다. 256×256×3개의 RGB 값을 직접 긴 시퀀스로 처리하는 대신 학습된 압축 표현을 다루는 것이죠. 따라서 이미지 생성 모델이라고 해서 GAN 구조를 쓰는 것은 아닙니다. DALL-E 1 원 논문
DALL-E 2: 의미 표현에서 이미지로
DALL-E 2의 큰 흐름은 다음과 같습니다.
- 텍스트 인코더가 프롬프트를 표현 벡터로 바꿉니다.
- prior 모델이 텍스트 정보를 조건으로 CLIP 이미지 임베딩을 예측합니다.
- diffusion 디코더가 그 임베딩 등을 조건으로 이미지를 생성합니다.
여기서 이미지 임베딩은 완성된 그림의 압축 파일이 아니에요. 의미를 담은 표현이므로 동일한 설명과 연결되는 다양한 이미지를 생성할 수 있습니다. 논문에서는 prior의 구조도 비교했으며 diffusion prior를 사용했습니다. DALL-E 2 원 논문
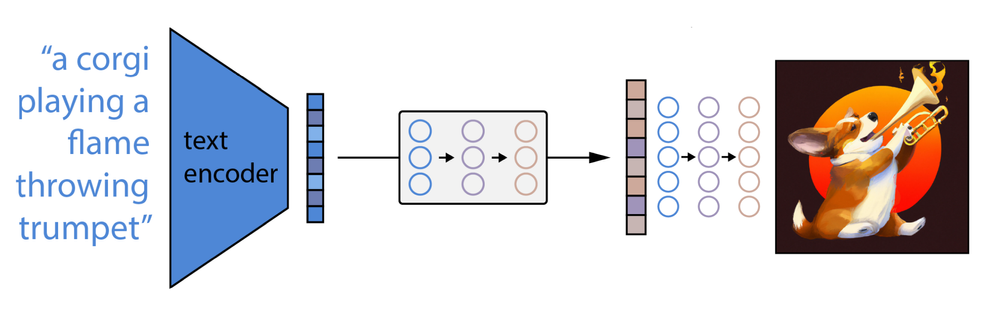 텍스트, CLIP 표현, 이미지 생성 모델의 역할을 나눈 구조
CLIP은 이미지를 그리는 모델일까?
CLIP은 이미지와 텍스트를 각각 벡터로 인코딩하고, 짝이 맞는 이미지·설명의 유사도는 높이고 잘못 짝지어진 경우는 낮추는 방향으로 학습합니다. 이 대조 학습이 두 종류의 정보를 연결하는 기반이 돼요.
다만 이를 사람이 글과 그림을 이해하는 것과 동일하게 보기는 어렵습니다. 텍스트·이미지의 관련성을 표현하는 능력과, 사물 개수나 위치 관계를 빠짐없이 지키는 능력도 구분해야 해요. 이미지 생성은 별도 모델이 맡습니다. CLIP 원 논문
API를 써보며 확인한 기능
당시 DALL-E 2 API는 텍스트 생성, 기존 이미지의 변형(variations), 마스크를 이용한 편집(edits)을 제공했습니다. 지원 크기는 256×256, 512×512, 1024×1024였습니다. 이는 당시 인터페이스 기록이며 새로 구현할 때는 현재 이미지 API 명세를 따로 확인해야 합니다.
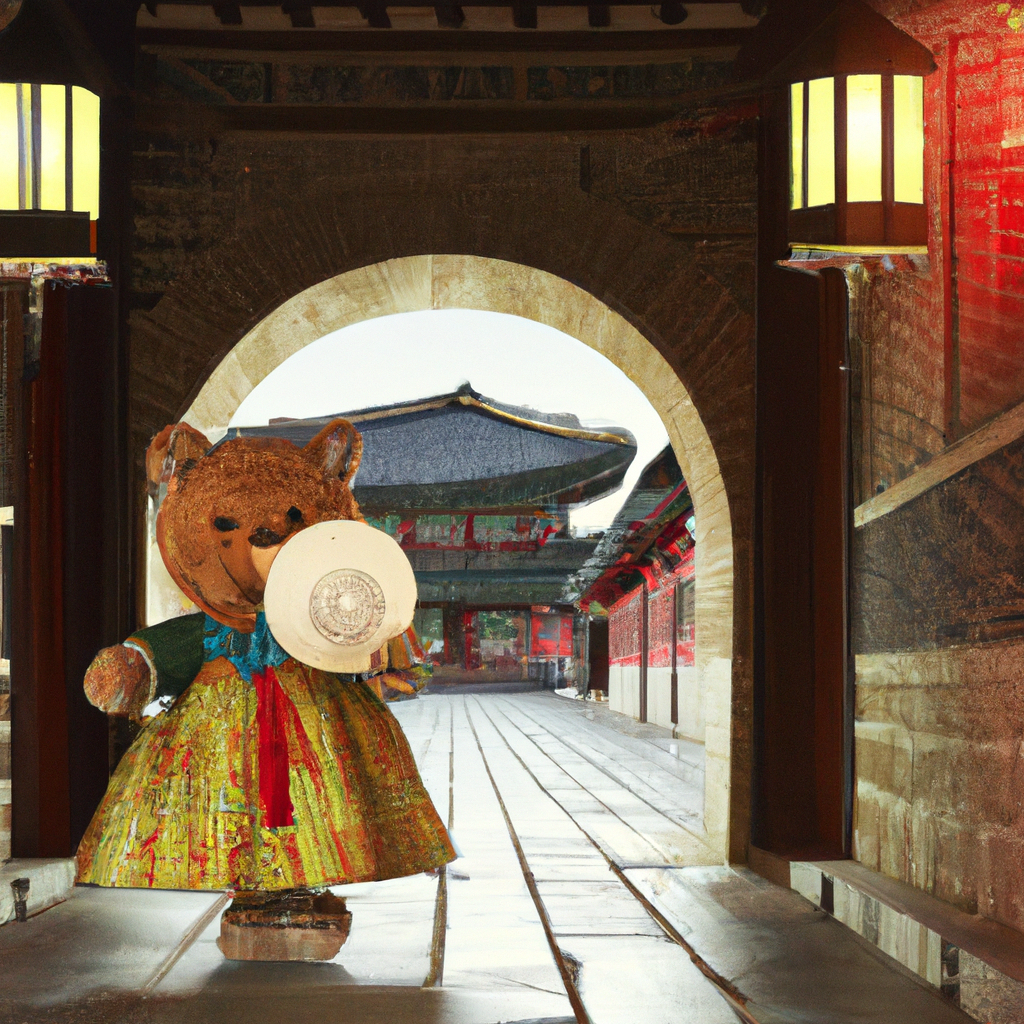 당시 “서울 경복궁 앞을 걸어가는 곰인형”을 주제로 생성한 예시
API를 제공해 주는 점은 편했어요. 하지만 당시 테스트에서는 한글 프롬프트 결과가 만족스럽지 않아 영어로 작성했습니다. 이것만으로 한국어를 전혀 지원하지 않는다고 결론 내릴 수는 없습니다. 언어 차이뿐 아니라 프롬프트 표현과 생성의 변동성도 결과에 영향을 줄 수 있기 때문입니다.
부분 편집과 캔버스 확장
부분 편집(inpainting)은 이미지 안에서 다시 생성할 영역을 지정하는 방식입니다. DALL-E 2의 마스크에서는 완전히 투명한 영역이 편집 대상입니다. 프롬프트는 원하는 결과를 설명하고, 마스크는 바꿀 위치를 지정하는 역할을 해요. 이미지 편집 API의 마스크 설명
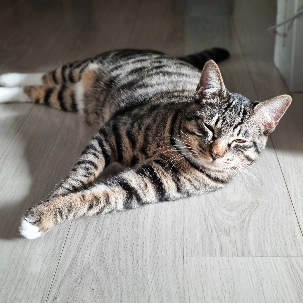 원본 이미지
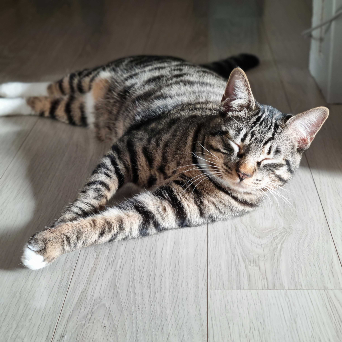 눈을 감은 표정으로 수정한 당시 결과
캔버스 확장(outpainting)은 새 캔버스에 원본을 놓고 바깥을 투명 영역으로 만든 뒤 편집을 요청하는 식으로 접근할 수 있습니다. 리사이즈는 크기를 바꾸는 작업이고, 확장 영역의 내용을 생성하는 것은 편집 모델의 작업입니다. 두 작업을 구분해야 파이프라인을 설계할 수 있어요. OpenAI의 DALL-E 2 기능 소개
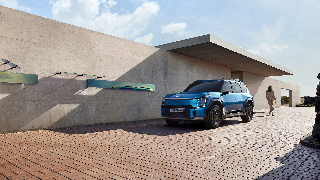 원본 이미지
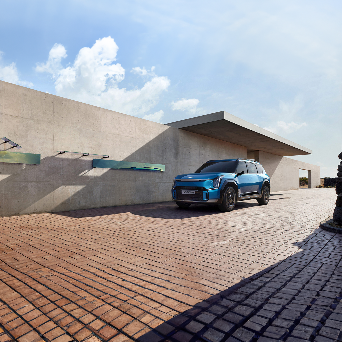 당시 기록한 사람 제거 및 크기 조정 결과. 처리 단계별 원본은 없어 각각의 효과를 분리해 비교하기는 어려움
제품 적용의 기준은 기능 수보다 실패 비용
당시에는 “API 기능이 적어 제품에 적용하기는 이르다”는 느낌이 들었습니다. 다만 기능 수만으로 제품 적합성을 판단하는 것은 성급해요. 생성 API 하나만으로도 충분한 제품이 있고, 편집 기능이 많아도 결과의 일관성이 부족하면 쓰기 어려운 제품이 있으니까요.
이 경험에서 도출할 수 있는 판단 기준은 사용자가 어떤 결과까지 허용할 수 있느냐입니다.
| 사용 흐름 | 먼저 검증할 것 | 필요한 제품 설계 |
|---|---|---|
| 아이디어·시안 탐색 | 여러 후보 중 쓸 만한 결과를 고를 수 있는가 | 재생성, 후보 비교, 사용자 선택 |
| 특정 영역 편집 | 대상이 바뀌고 주변 맥락이 자연스럽게 이어지는가 | 마스크 미리보기, 원본과 결과 비교, 되돌리기 |
| 정확한 제품 이미지 제작 | 형태·색·텍스트 등 지켜야 할 조건을 만족하는가 | 합격 기준, 검수, 실패 시 원본 유지 |
위 표는 새로 측정한 결과가 아니라 당시 경험을 제품 요구에 연결한 평가 방법입니다. 샘플 한 장이 잘 나오는지보다 같은 종류의 요청을 반복했을 때 얼마나 자주 사람이 고쳐야 하는지를 확인해야 합니다.
한글 입력을 영어로 번역하는 단계도 자동으로 필수라고 정할 필요는 없어요. 같은 의도의 한국어·영어 프롬프트를 비교해 개선이 있는지 확인한 뒤 추가하는 편이 낫습니다. 리사이징 역시 최종 결과를 자르는 것인지, 비율을 유지하며 여백을 넣는 것인지, 새 내용을 생성해 확장하는 것인지 목적부터 정해야 하고요.
제 2023년 사용 경험에서는 API 연결보다 결과를 원하는 수준으로 통제하는 일이 더 어려웠습니다. 제품 도입 여부는 그 간극을 재시도·편집·검수 흐름으로 감당할 수 있는지에 달려 있다고 봅니다.