애플의 LLM 하이퍼파라미터 전이 연구: Complete(d) Parameterisation
작은 모델에서 찾은 학습 설정을 큰 모델에 그대로 복사하면 될까요? 모델의 폭과 깊이뿐 아니라 배치 크기, 학습할 토큰 수가 달라지면 같은 숫자가 같은 학습 동작을 의미하지 않을 수 있습니다.
애플 연구진의 Completed Hyperparameter Transfer across Modules, Width, Depth, Batch & Duration은 작은 모델에서 탐색한 설정을 규모에 맞게 변환해 전이하는 방법을 다룹니다. 방법 이름은 Complete(d) Parameterisation입니다. 추론용 모델을 압축하는 기법이나, 이미 학습한 가중치를 단순히 큰 모델에 복사하는 기법은 아닙니다.
이 글의 수치와 그림은 논문 v1 기준입니다. 제가 학습 실험을 재현한 결과는 아닙니다.
먼저 볼 결과: 같은 손실에 더 적은 학습량
연구진은 50M 모델에서 하이퍼파라미터를 탐색하고, 전이 규칙으로 변환해 7.2B 모델에 적용했습니다.
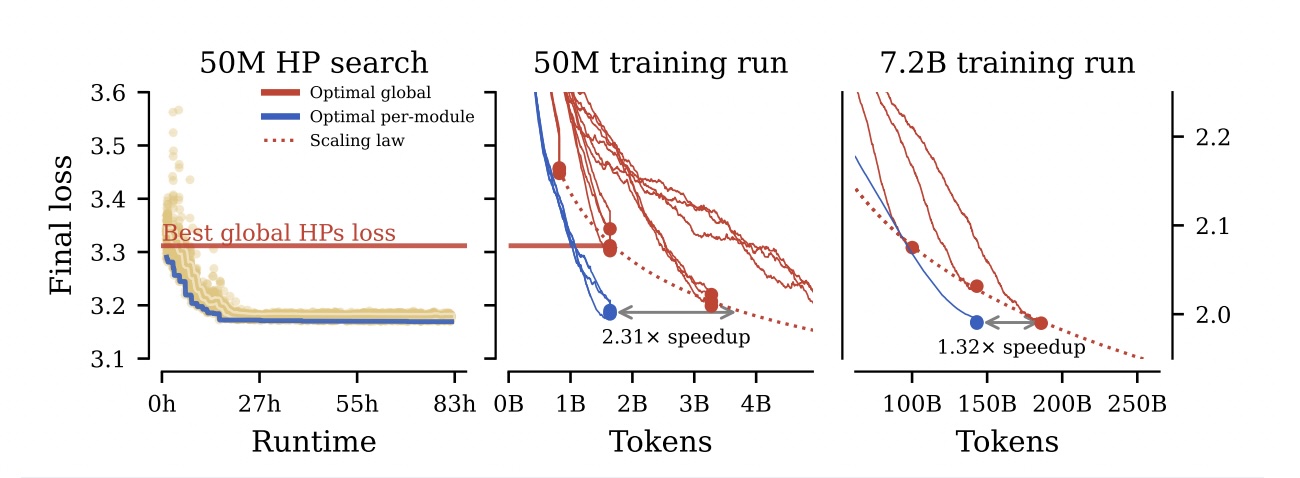 Figure 1. 왼쪽은 탐색 경과, 가운데와 오른쪽은 학습 토큰 수에 따른 손실입니다. 실선·점선과 비교 지점을 함께 읽어야 합니다.
| 비교 | 논문 Figure 1의 결과 | 의미 |
|---|---|---|
| 50M의 전역 설정과 모듈별 설정 | 2.31배 효율 | 비교한 손실에 도달하는 데 필요한 학습량 차이 |
| 설정을 전이한 7.2B | 1.32배 효율 | 큰 모델에서 추가 탐색 없이 유지된 이득 |
그래프의 가로축은 토큰 수입니다. GPU가 초당 처리하는 토큰 수나 사용자 응답 속도가 1.32배 빨라졌다는 뜻이 아닙니다. 또한 그림의 배수는 특정 학습 곡선과 비교 지점에 대한 결과이므로 모든 학습 예산에 적용되는 상수로 쓰면 안 됩니다. 논문 Figure 1
무엇을 ‘전이’하는가
하이퍼파라미터는 학습률, 초기화 스케일, 가중치 감쇠, AdamW의 모멘텀 등 학습 방식을 정하는 값입니다. 학습으로 얻는 가중치와 구분해야 합니다.
μP와 후속 연구는 작은 모델에서 찾은 설정을 모델 크기에 맞게 바꾸는 규칙을 연구해 왔습니다. Complete(d)P는 CompleteP를 조정하고, 폭·깊이뿐 아니라 배치와 총 학습 토큰 수까지 포함합니다. 중요한 것은 “좋은 학습률 하나를 발견했다”보다 서로 다른 규모에서 설정을 비교할 좌표계를 맞춘다는 관점입니다.
여기에 모듈별 설정을 결합합니다. QKV, MLP, 정규화, 임베딩 등 서로 다른 역할의 텐서에 동일한 기준값을 강제하는 대신, 작은 모델에서 세분화한 설정을 찾아 큰 모델로 옮길 수 있는지 확인합니다. 논문 1–3절
제곱근 규칙은 학습률만 바꾸는 공식이 아니다
논문은 배치 변화에 따른 그래디언트 잡음과 학습 과정을 확률 미분 방정식(SDE) 관점에서 근사합니다. 여기서 얻는 규칙은 특정 근사가 성립하는 범위에서 쓰는 전이 기준이지, 임의의 배치 크기에서도 학습이 똑같다는 보장은 아닙니다.
폭·깊이·총 학습 토큰 수를 고정하고 배치 크기만 $\kappa$배 키우는 경우를 보겠습니다. PyTorch 방식의 AdamW에 대해 논문이 제시한 조정은 다음과 같습니다.
| 항목 | 변환 |
|---|---|
| 학습률 $\eta$ | $\eta’ = \sqrt{\kappa}\eta$ |
| 가중치 감쇠 $\lambda$ | $\lambda’ = \sqrt{\kappa}\lambda$ |
| AdamW $\epsilon$ | $\epsilon’ = \epsilon / \sqrt{\kappa}$ |
| 모멘텀의 보수 | $1-\beta_i’ = \kappa(1-\beta_i)$, $i=1,2$ |
| 총 업데이트 횟수 | 기존의 $1/\kappa$ |
출처: 논문 Table 1과 2.2절. 마지막 행은 총 토큰 수를 고정했기 때문에 배치가 커진 만큼 업데이트 횟수가 줄어드는 관계입니다. 폭·깊이까지 바꾸려면 텐서 종류별 추가 규칙도 적용해야 합니다.
검산용 예를 들어 배치를 4배로 키우면 학습률과 감쇠는 2배, $\epsilon$은 절반, $1-\beta_i$는 4배가 됩니다. $\beta_1=0.9$였다면 $\beta_1’=0.6$입니다. $\beta_1$ 자체를 4배로 만드는 것이 아닙니다. 이 숫자는 추천 설정이 아니라 수식의 의미를 확인하기 위한 예입니다.
이 계산만 보아도 배치를 끝없이 키울 수 없는 이유가 드러납니다. $\kappa$가 너무 크면 계산한 $\beta_i’$가 유효 범위를 벗어날 수 있습니다. 값이 유효하더라도 근사와 전이 성질이 유지되는지는 확인해야 합니다.
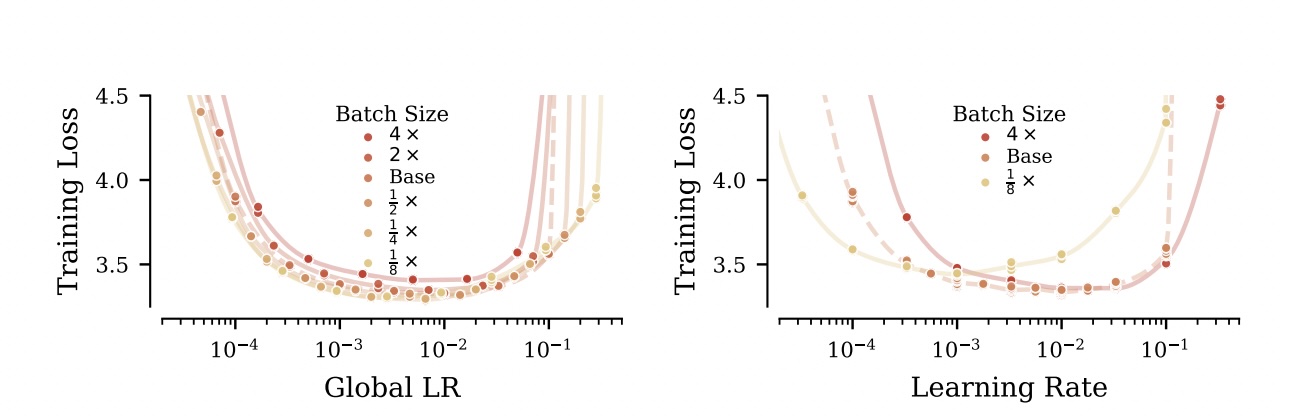 Figure 3. 보정한 학습률 좌표에서는 좋은 설정의 위치가 모이고, 보정하지 않으면 배치에 따라 위치가 달라집니다. 학습률에 따른 최종 손실을 비교한 그림입니다.
구현 차이도 중요합니다. 위 감쇠 규칙은 감쇠 항에 학습률을 곱하는 PyTorch 방식에 대한 것입니다. 논문은 AdamLH라고 부르는 다른 관례에서는 감쇠의 배율이 달라진다고 설명합니다. 옵티마이저 이름만 확인하지 말고 실제 업데이트 식을 확인해야 하는 이유입니다.
더 오래 학습할 때는 다른 방향으로 조정한다
배치를 고정하고 총 토큰 수를 늘리면 업데이트 횟수가 늘어납니다. 논문은 학습 기간 축에 대한 별도의 SDE 기반 전이 규칙을 다루며, 실험한 조건에서 학습 기간이 늘수록 적절한 학습률이 낮아지는 패턴을 보고합니다. 배치를 키우는 경우와 학습 기간을 늘리는 경우를 같은 ‘규모 확대’로 묶으면 조정 방향을 혼동하게 됩니다.
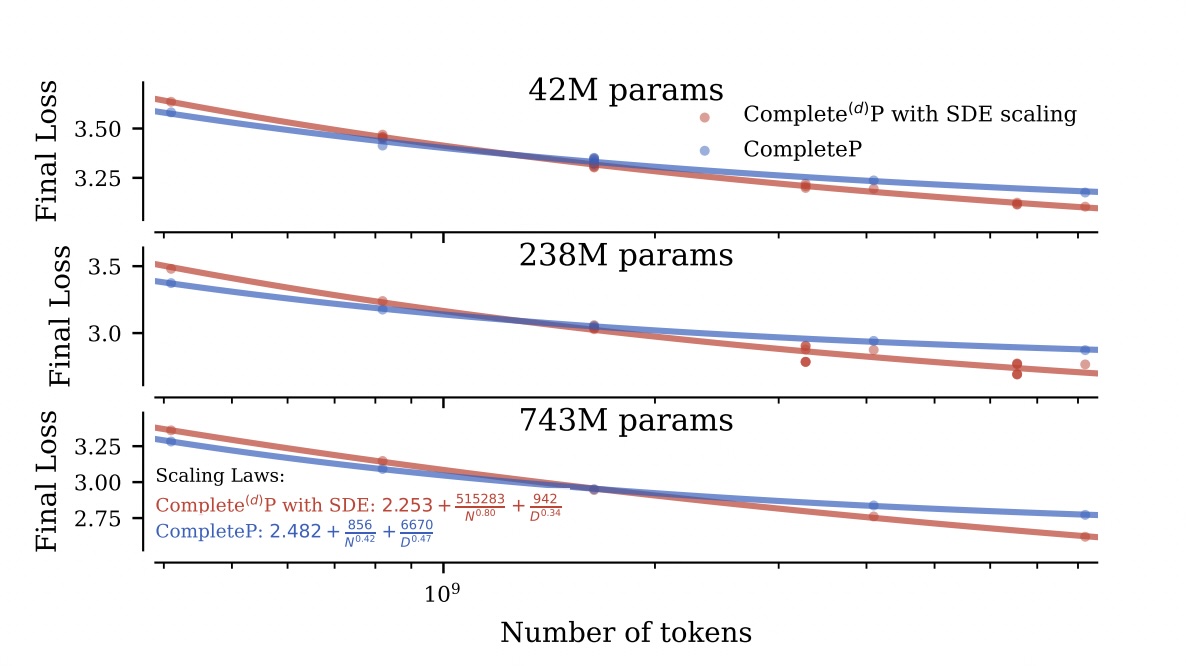 Figure 6. 토큰 수에 따른 손실 비교. 빨간색은 학습 기간에 대한 SDE 조정까지 포함한 방식, 파란색은 비교 대상 CompleteP입니다.
핵심 질문은 “더 크게 학습하니 학습률도 키울까?”가 아니라 폭·깊이·배치·토큰 중 무엇을 바꿨고 무엇을 고정했는가?입니다. 전체 조정은 논문 Table 1과 2.3절을 함께 봐야 합니다.
작은 모델에서 찾는 것도 공짜는 아니다
모듈별 탐색은 총 79개의 하이퍼파라미터를 다룹니다. 큰 모델에서 직접 탐색하기보다 작은 모델을 쓰는 것은 유리할 수 있지만, ‘작다’는 표현이 곧 저렴함을 뜻하지는 않습니다.
논문 Appendix D.3은 작은 규모 탐색에 A100 기준 6,730 GPU-hours가 들었다고 보고합니다. 이 비용은 7.2B 모델 학습 비용과도 구분해야 합니다.
그래서 제가 이 결과를 실제 투자 판단으로 옮긴다면 다음 관계부터 볼 것 같습니다.
탐색·구현·검증의 추가 비용 < 전이할 학습 작업들에서 절약할 총비용
한 번의 작은 학습만 한다면 전역 설정 몇 개를 조정하는 편이 나을 수 있습니다. 비슷한 구조의 큰 모델을 반복 학습하고 설정을 재사용할 수 있다면 높은 탐색 비용을 회수할 여지가 커집니다. 이는 비용 구조에 관한 해석이며 논문이 모든 팀에 대해 계산한 손익분기점은 아닙니다.
재현하거나 적용할 때의 최소 확인 사항
- 구조와 구현: 논문이 가정한 텐서 종류, 정규화, AdamW 업데이트 식과 맞는가?
- 축의 분리: 폭·깊이·배치·토큰 수를 한 번에 바꾸기 전에 각 축의 전이를 확인했는가?
- 공정한 비교: 이미 튜닝한 전역 설정을 기준으로 같은 데이터·예산에서 비교하는가?
- 성공의 기준: 손실 개선과 실제 과제 성능, 전체 GPU 비용을 구분해 기록하는가?
논문의 실험은 RedPajama, decoder-only Transformer, 코사인 스케줄에 기반합니다. 다른 구조·데이터·미세조정 방법까지 같은 전이 규칙과 이득이 성립한다고 가정할 수는 없습니다.
이 연구의 가치는 대규모 학습에서 비싼 시행착오를 줄일 방법을 제시한 데 있습니다. 좋은 설정을 무작정 복사하기보다 어떤 변화에도 좋은 설정으로 남도록 변환 규칙을 설계한다는 발상이 핵심입니다.