배치 작업 어디까지 해봤니?
서비스를 구축하다 보면 많은 데이터를 한꺼번에 변경해야 할 때가 옵니다. 이때 중요한 것은 작업을 끝내는 속도와, 그동안 서비스에 주는 부담 사이의 균형입니다.
이번 글은 MongoDB와 Node.js로 50만 건을 갱신하며 구현을 바꿔본 기록입니다. 처음에는 Promise.all로 시작했고, bulkWrite, 분할 처리, 커서까지 적용해봤어요. 돌아보면 핵심은 특정 API를 고르는 것보다 한 번에 메모리에 보관하는 양과 DB에 밀어 넣는 작업량을 제한하는 것이었습니다.
아래 환경·화면·측정값은 2022년 실험 기록입니다. 해석의 한계와 수정 예제를 보완했으며, 과거 환경을 다시 실행하거나 새로운 성능 수치를 측정한 것은 아닙니다. 당시 버전을 신규 서비스의 권장 버전으로 제시하지 않습니다.
테스트 환경과 확인하려던 것
- Cloud: Tencent Cloud CVM
- CPU/RAM: 2core / 2GB
- Database: MongoDB WT 4.2.19
- Runtime: Node.js v14.19.0, NestJS
- 데이터: TestA와 TestB 컬렉션에 각각 50만 개의 document
1
2
TestA: { name: string }
TestB: { name: string, aId: string }
TestA를 읽어 대응하는 TestB를 갱신하는 작업입니다. 배치는 작업을 묶어 처리하는 방식이고, 반드시 새벽에 실행하거나 모든 데이터를 하나의 트랜잭션에 넣어야 하는 것은 아닙니다. 야간에도 같은 DB를 쓰는 서비스가 있다면 영향을 확인해야 합니다.
먼저 당시 기록을 한 표로 모아보겠습니다.
| 시도 | 읽기·쓰기 구조 | 기록된 소요 시간 | 기록된 CPU 관찰 |
|---|---|---|---|
| Take1 | 전체 조회 후 다수의 updateOne을 Promise.all로 실행 | 메모리 부족으로 실패 | 비교 가능한 수치 없음 |
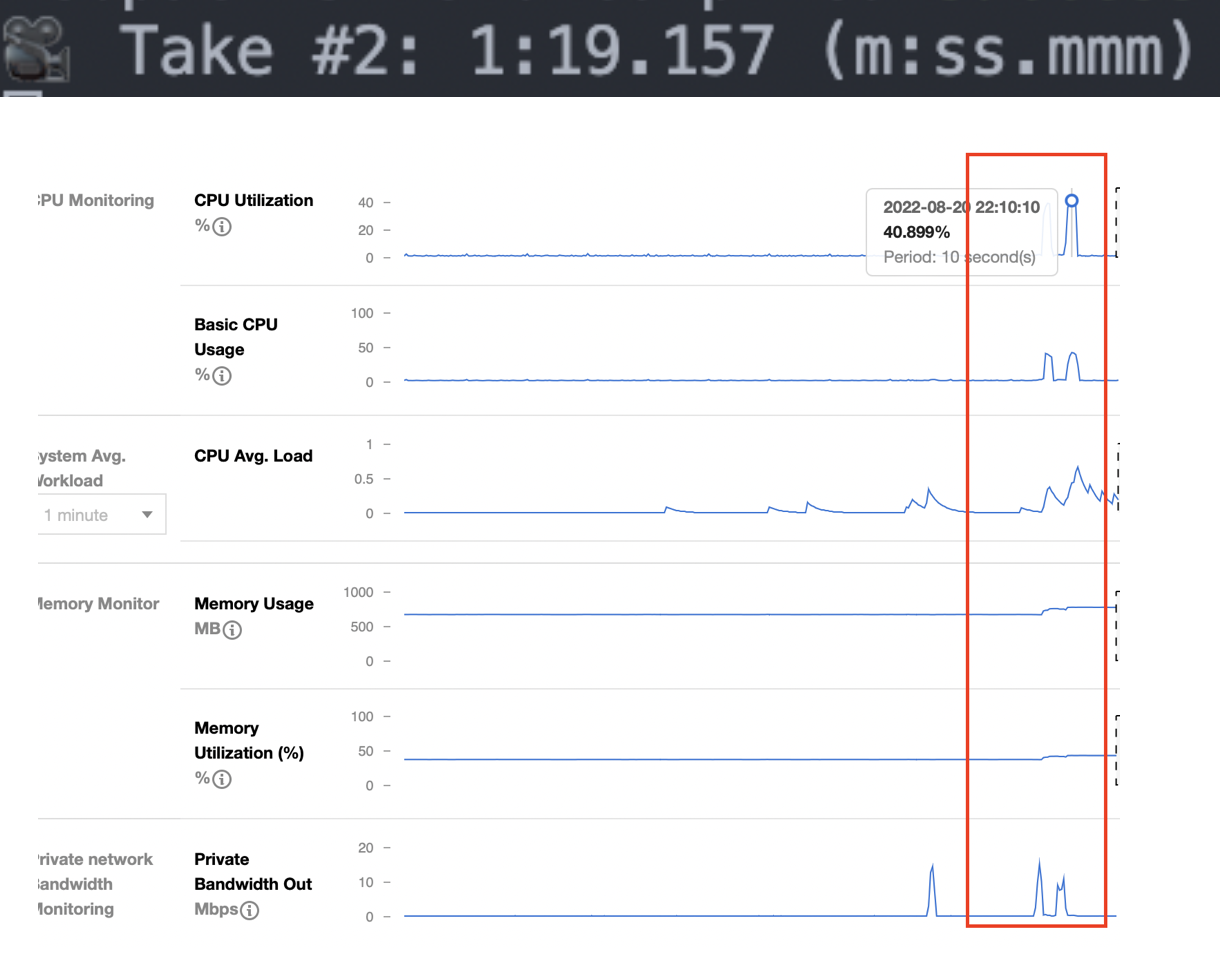
| Take2 | 전체 조회 후 bulkWrite | 1분 19초 | 약 40% |
| Take3 | 10,000개씩 조회·쓰기 | 1분 25초 | 약 22% |
| Take4 | 커서로 읽고 10,000개씩 쓰기 | 11분 55초 | 앞선 방식보다 낮게 관찰 |
CPU 값의 집계 구간, 반복 횟수, 인덱스 구성, 동시 사용자 부하는 충분히 기록하지 못했습니다. 따라서 이 표는 그때 관찰한 결과이지, 각 방식의 보편적인 성능 순위는 아닙니다.
Take1: Promise.all은 동시 실행 수를 제한하지 않는다
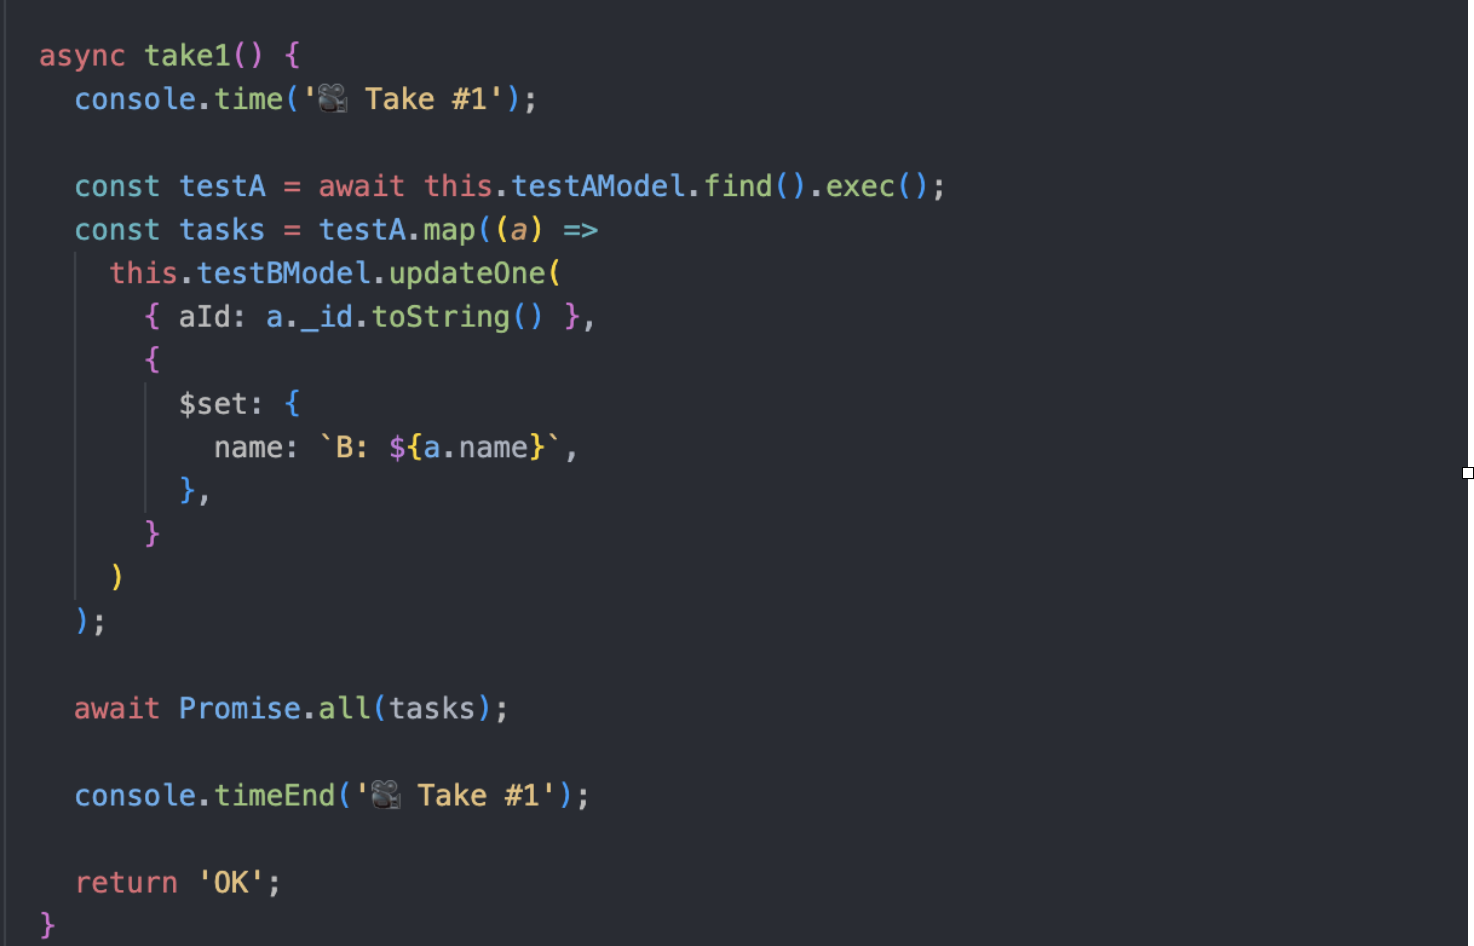 Take1의 원본 실험 코드
전체 조회 결과를 배열로 보관하고, 각 document의 updateOne 작업을 한꺼번에 준비했습니다. 결과는 힙 메모리 부족이었습니다.
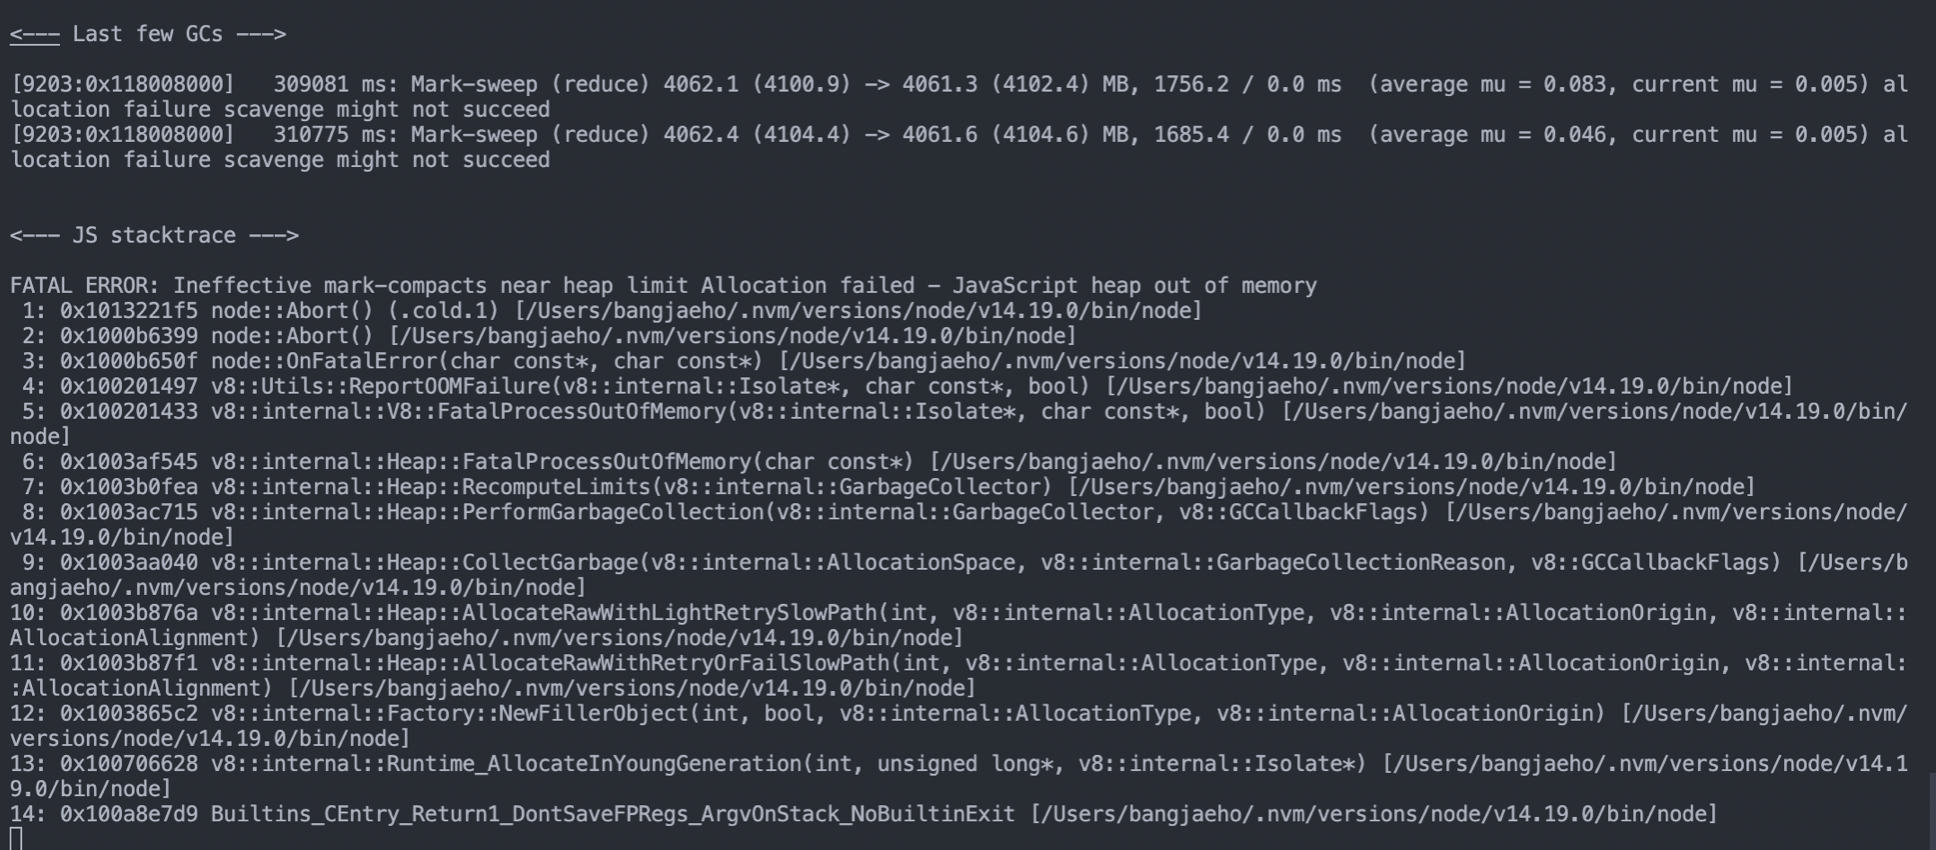
DB 연결 풀이 실제 연결 수를 제한하더라도, 애플리케이션에서 만든 문서 객체·Promise·대기 작업까지 사라지는 것은 아닙니다. 메모리 부족이 발생했다고 반드시 누수인 것도 아니에요. 정상적으로 참조 중인 데이터 자체가 너무 많아도 한도를 넘을 수 있습니다.
--max-old-space-size는 V8 old space 한도를 바꾸는 옵션입니다. 프로세스 전체 RSS 한도가 아니며, 2GB 서버에서 무작정 늘리면 운영체제나 DB에 필요한 여유를 줄일 수 있습니다. 당시 Node.js 14 문서를 기준으로 옵션의 범위를 구분해야 합니다.
Take2: bulkWrite로 쓰기를 묶는다
bulkWrite로 바꾸자 50만 건 작업이 끝났습니다. 당시 기록은 1분 19초, CPU 약 40%였습니다.
bulkWrite는 여러 쓰기 작업을 묶어 전달하는 인터페이스입니다. 개별 호출의 부담을 줄일 수 있지만, 전체 조회 결과와 작업 배열을 여전히 모두 만들면 메모리 사용량은 데이터 수에 따라 커집니다.
또한 bulk라는 이름이 전체 성공 또는 전체 실패를 뜻하지는 않습니다. 트랜잭션 밖에서는 일부 쓰기가 성공한 뒤 오류가 날 수 있습니다. 기본 ordered: true는 오류 뒤의 작업을 중단하고, ordered: false는 나머지 작업을 계속 시도할 수 있습니다. 후자는 순서가 중요하지 않은 작업에서 검토해야 하며 항상 더 빠르다는 보장은 없습니다. MongoDB bulkWrite의 실행·오류 동작에 설명돼 있습니다.
CPU 40% 자체만으로 서비스에 문제가 있다고 말할 수는 없습니다. 작업 중 온라인 요청의 지연·오류가 증가했는지, DB의 I/O나 복제 지연은 어땠는지까지 봐야 합니다.
Take3: 10,000개씩 나눠 처리한다
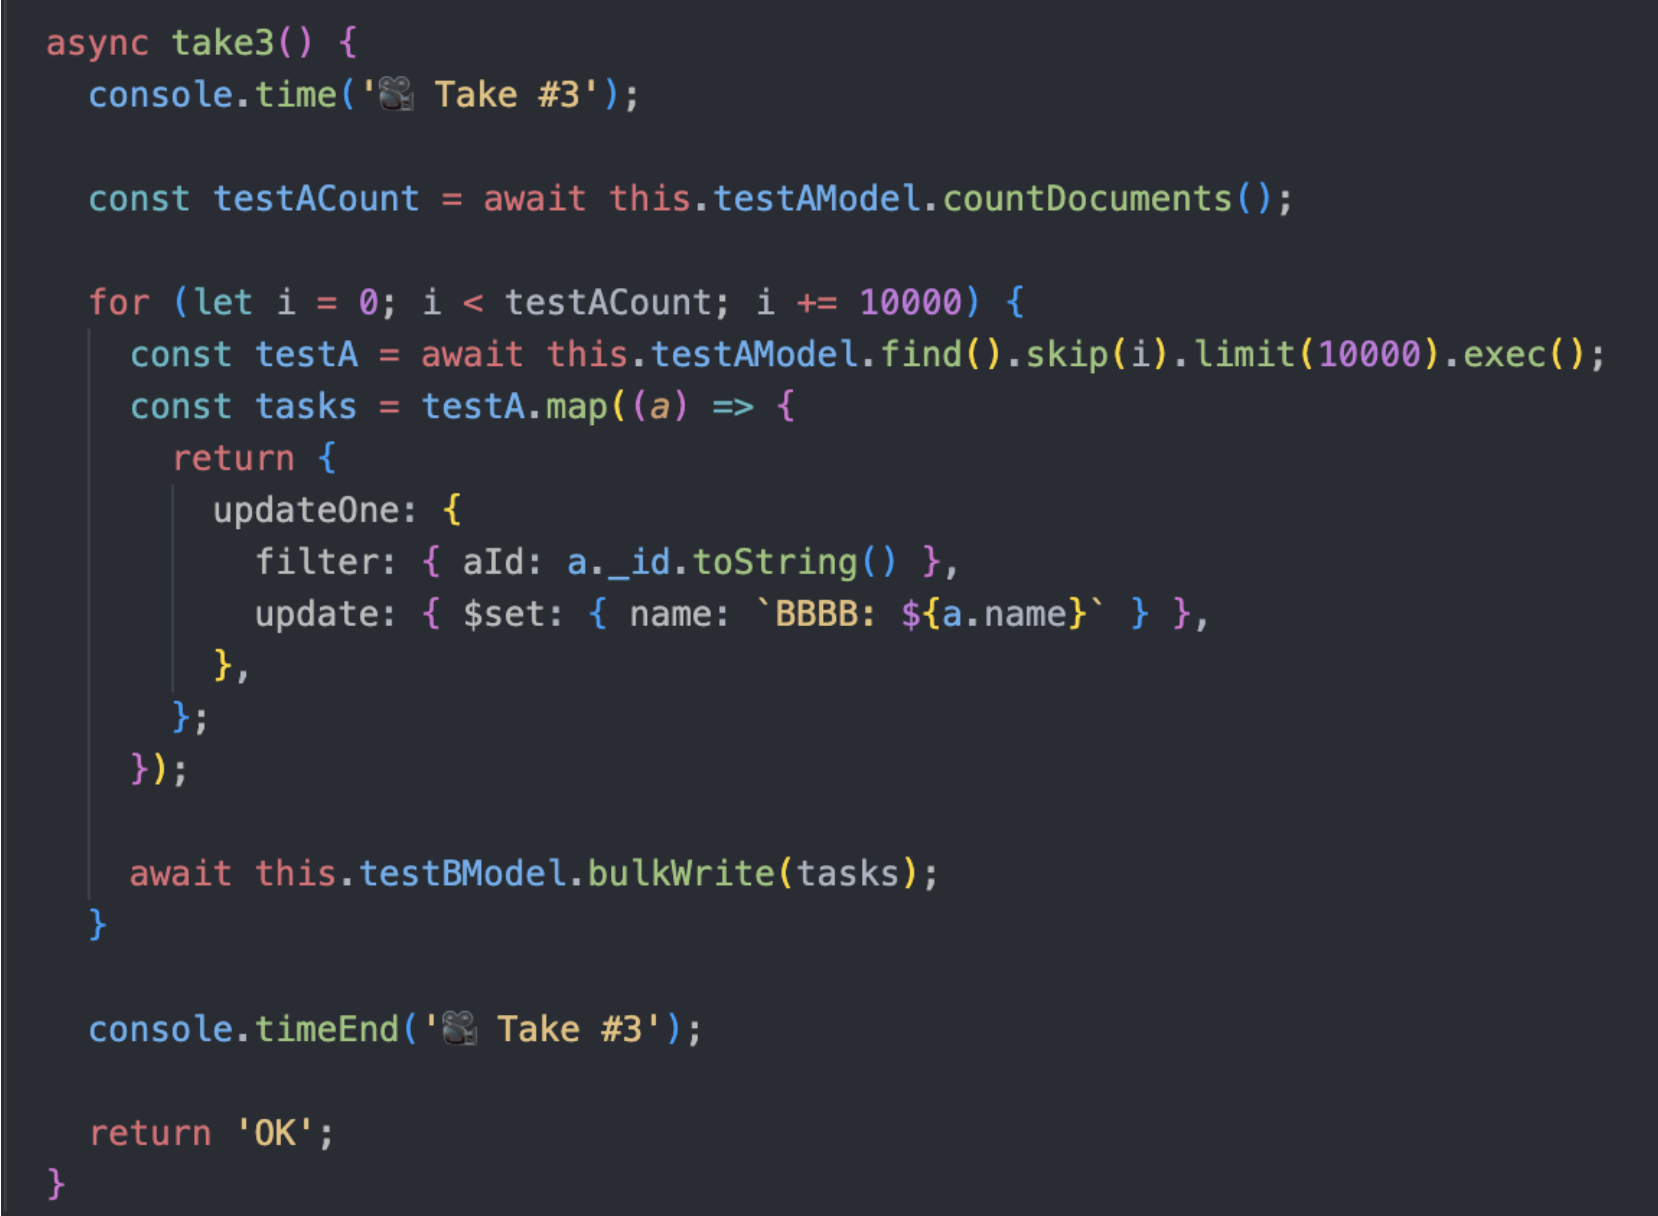 Take3의 원본 실험 코드
한 번에 읽고 쓰는 양을 10,000개로 줄였습니다. 실행 시간은 1분 25초였고 CPU 사용률은 약 22%로 관찰됐습니다.
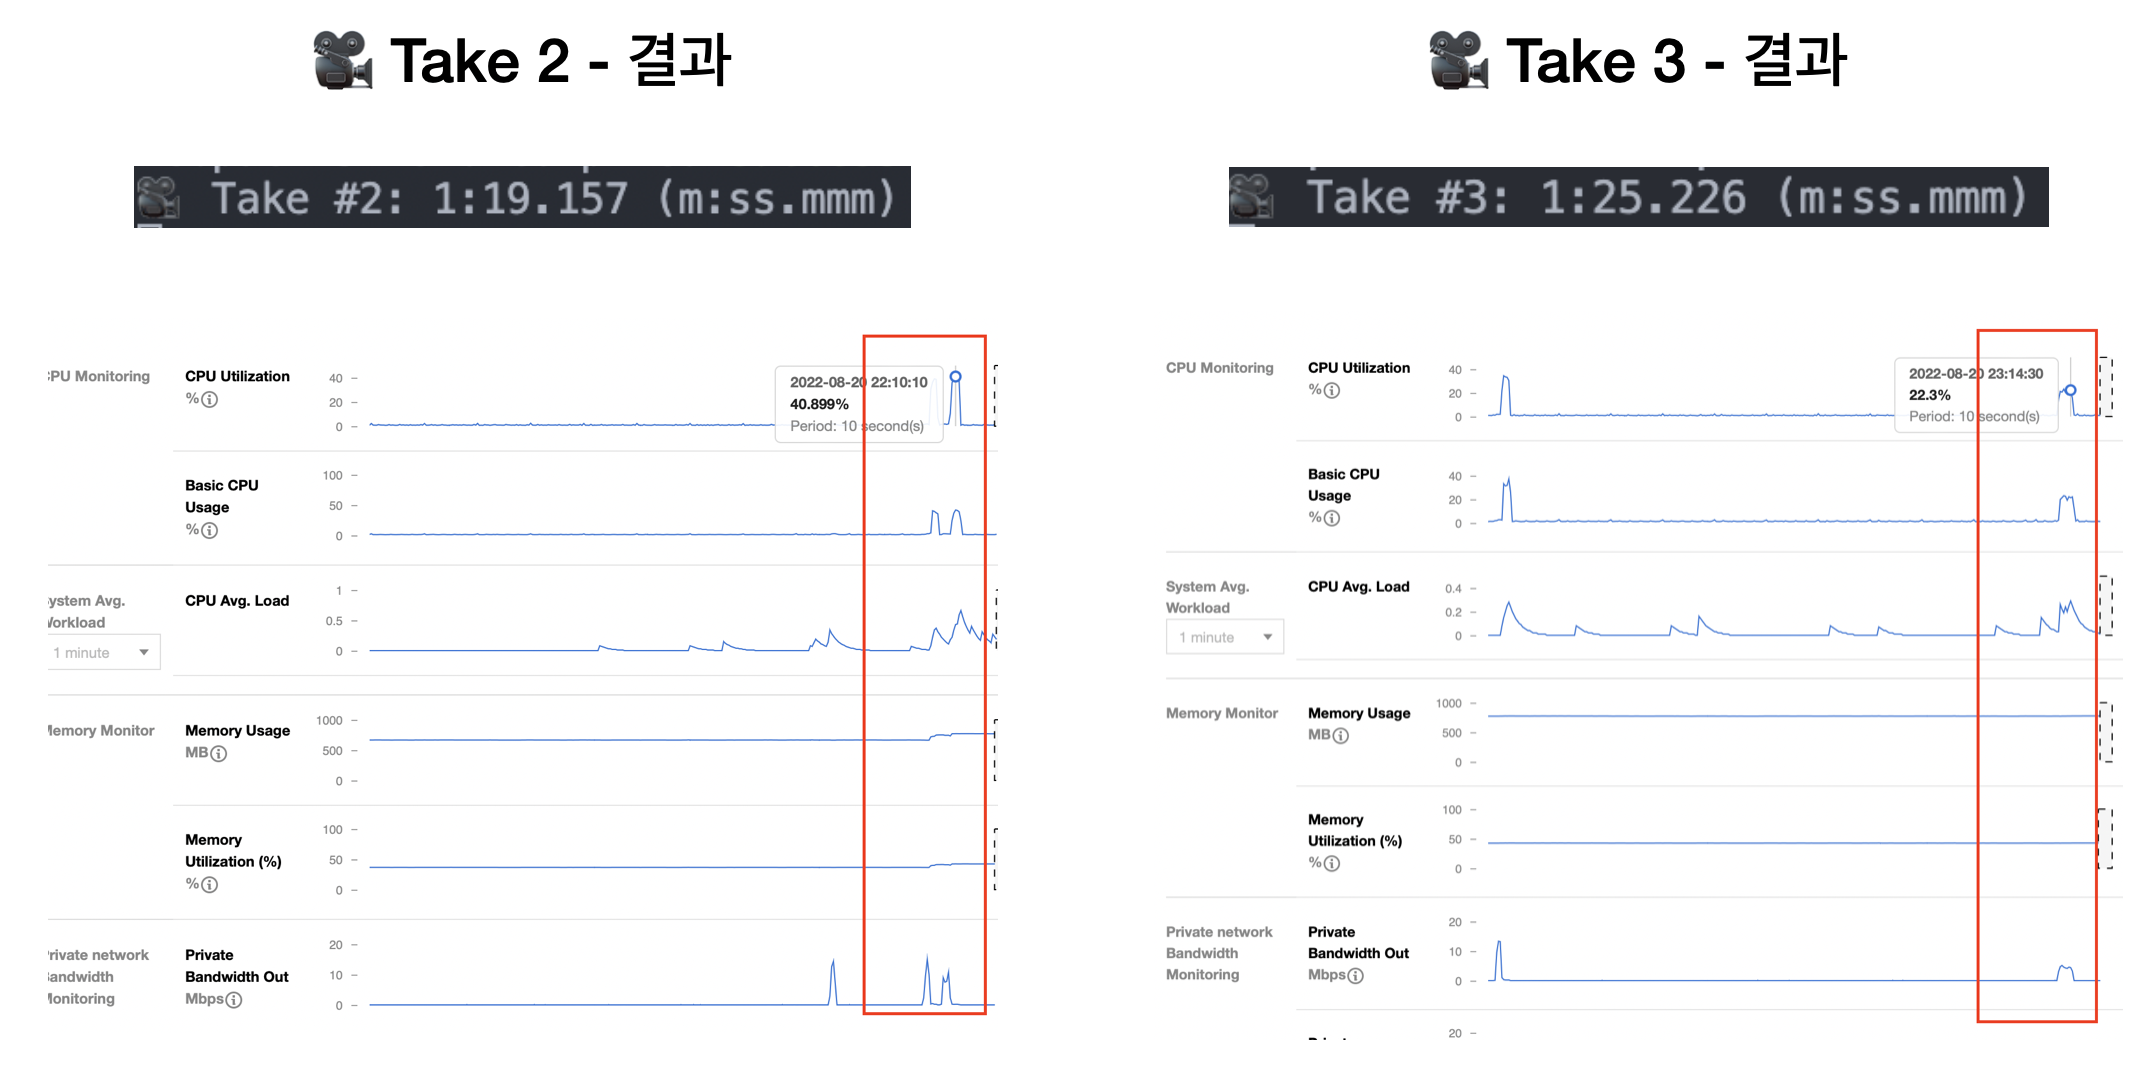
이 실험에서는 소요 시간이 비슷한 상태에서 CPU가 낮아졌습니다. 하지만 평균·최댓값의 구분과 반복 측정이 없어 “절반의 자원으로 같은 일을 한다”까지 일반화할 수는 없습니다.
분할 크기도 문서 개수만으로 정하기 어렵습니다. 문자열 몇 개가 있는 문서 1만 개와 큰 배열이 든 문서 1만 개는 메모리 사용량이 다르니까요. MongoDB의 BSON 문서 하나는 최대 16MiB이며, 조회 결과 전체를 40MB로 제한하는 일반 규칙은 없습니다. 큰 결과는 커서의 여러 배치로 전달됩니다. MongoDB 크기 제한과 애플리케이션이 실제 보관하는 객체 크기를 구분해야 합니다.
이때 사용한 skip() 기반 분할에도 한계가 있습니다. 뒤쪽 페이지로 갈수록 앞의 결과를 건너뛰는 비용이 커질 수 있고, 작업 중 데이터가 삽입·삭제되면 페이지 경계가 움직입니다. 고유한 정렬 기준을 두고 마지막 처리 키 이후를 조회하는 범위 방식도 후보입니다. 다만 범위 조회 역시 작업 대상의 시점과 변경 정책을 자동으로 고정해주지는 않습니다. MongoDB의 skip과 범위 조회 비교를 참고하세요.
Take4: 커서로 읽고 쓰기 완료를 기다린다
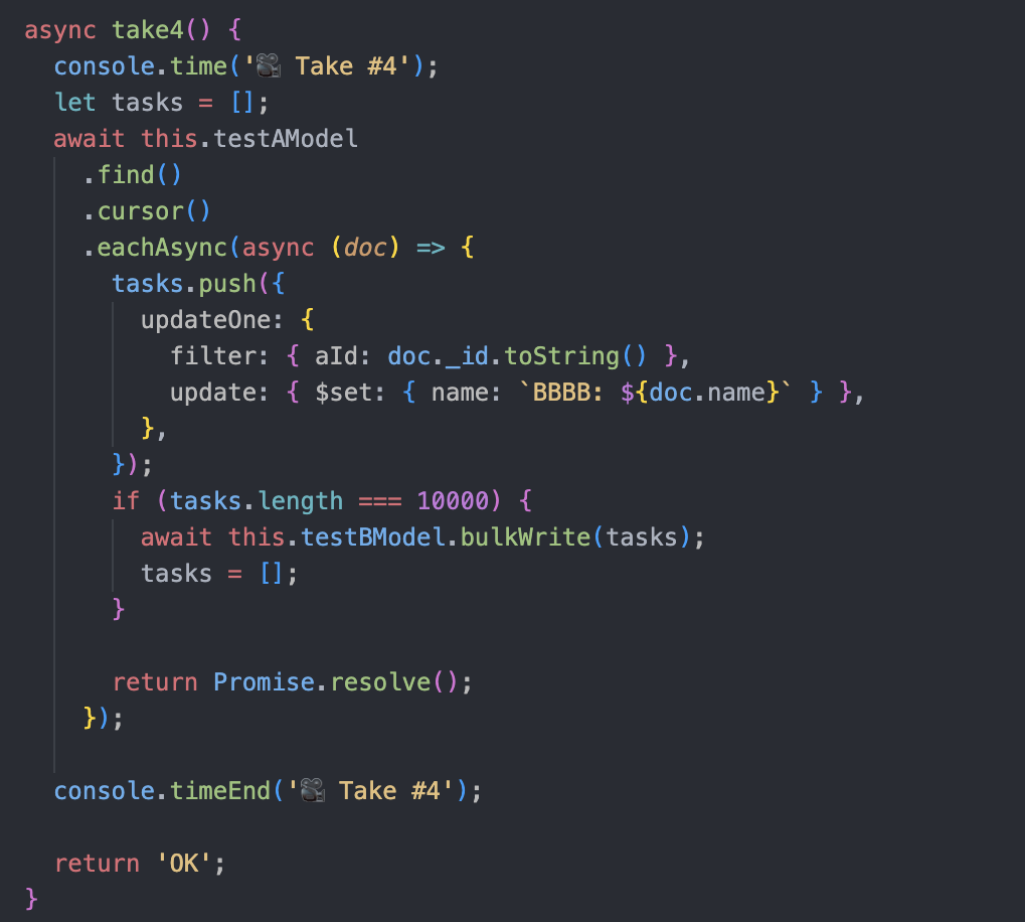 원본 코드에는 마지막 잔여 작업 처리 누락이 있으므로 아래 수정 예제를 참고하세요.
Mongoose의 cursor()를 사용해 조회 결과를 한꺼번에 배열로 만들지 않고 순차적으로 읽었습니다. 당시 소요 시간은 11분 55초로 늘었고 CPU 사용률은 낮아졌습니다.
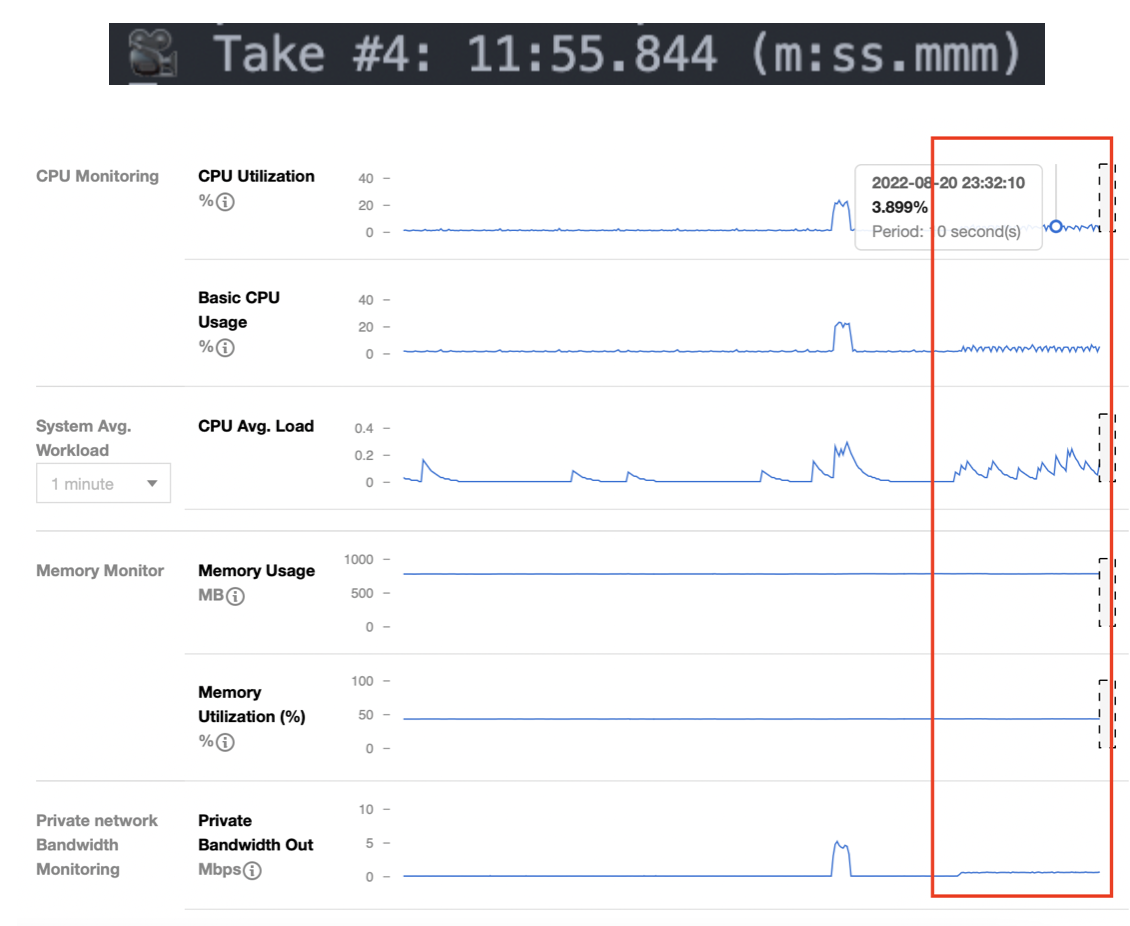
이 결과만으로 커서는 원래 느리다고 결론 내릴 수는 없습니다. 읽기 배치 크기, 문서 변환, 콜백의 대기 방식, 쓰기 배치, 인덱스 등을 각각 확인해야 합니다. 커서는 데이터를 가져오는 방식이고, 처리 속도는 그 데이터를 소비하는 방식에도 좌우됩니다. Mongoose 6 QueryCursor 문서는 순차 순회와 비동기 처리 옵션을 설명합니다.
특히 원본은 마지막에 10,000개 미만이 남으면 쓰지 않는 문제가 있었습니다. 50만은 1만으로 나누어떨어지므로 이 데이터만으로는 누락을 발견하기 어렵습니다. 10,001개 같은 경계값으로 검증해야 하는 이유입니다.
수정 예제: 읽기 버퍼와 쓰기 배치를 제한한다
다음은 두 Mongoose 모델을 인자로 받는 JavaScript 함수입니다. Mongoose 6의 커서 API를 기준으로, TestA 하나에 TestB 하나가 대응하고 aId는 문자열인 위 스키마를 가정합니다. 운영 이관 도구 전체가 아니라 누락 없이 제한된 양을 처리하는 핵심 예제입니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
export async function syncNames(testAModel, testBModel, batchSize = 1000) {
  if (!Number.isSafeInteger(batchSize) || batchSize < 1) {
    throw new RangeError('batchSize must be a positive integer');
  }

  const cursor = testAModel
    .find({})
    .select({ _id: 1, name: 1 })
    .sort({ _id: 1 })
    .lean()
    .cursor({ batchSize });

  let tasks = [];
  let submitted = 0;

  async function flush() {
    if (tasks.length === 0) return;
    await testBModel.bulkWrite(tasks, { ordered: true });
    submitted += tasks.length;
    tasks = [];
  }

  try {
    for await (const doc of cursor) {
      tasks.push({
        updateOne: {
          filter: { aId: String(doc._id) },
          update: { $set: { name: doc.name } },
        },
      });
      if (tasks.length >= batchSize) await flush();
    }
    await flush(); // 마지막에 batchSize 미만으로 남은 작업도 반영
    return { submitted };
  } finally {
    await cursor.close();
  }
}
쓰기 배치가 끝나야 다음 문서를 소비하므로 애플리케이션의 미완료 쓰기가 무한히 쌓이지 않습니다. 조회의 batchSize와 쓰기 배열 크기는 서로 다른 조절 대상입니다. 예제에서는 같은 수를 썼을 뿐, 최적값이 같다는 뜻은 아닙니다. .lean()은 Mongoose document 대신 일반 객체로 읽는 선택이며, getter·virtual 등 document 기능에 의존하는 작업이라면 그대로 적용하면 안 됩니다.
submitted는 오류 없이 제출을 마친 작업 수입니다. 실제로 TestB를 찾았거나 값이 바뀐 수와 같지 않습니다. bulkWrite 결과의 매칭·수정 수를 별도로 확인하고, aId가 중복될 수 있다면 updateOne이 의도에 맞는지도 검토해야 합니다. 조회 조건에 맞는 인덱스 역시 배치 크기보다 먼저 확인할 항목입니다.
Mongoose의 bulkWrite는 개별 save()와 같은 미들웨어 경로를 실행하지 않습니다. 저장 훅에 업무 규칙을 넣었다면 이관 과정에서도 적용되는지 따로 확인해야 합니다. Mongoose 6 bulkWrite 문서가 이 차이를 설명합니다.
다시 실행해야 한다면?
위 예제는 오류를 호출자에게 전달하고 커서를 닫습니다. 자동 재개나 정확히 한 번 처리를 보장하지는 않습니다. 일부가 반영된 상태에서 중단될 수 있어 다음을 결정해야 합니다.
- 재실행의 의미: 같은 값으로
$set하는 작업은 원본과 대상이 변하지 않는 조건에서 반복해도 결과가 같습니다.$inc나 알림 발송은 그대로 재실행하면 중복 효과가 납니다. - 작업 대상의 시점: 진행 중 원본이 바뀌어도 되는지, 고정된 대상 목록이나 버전 조건이 필요한지 정합니다.
- 체크포인트: 배치의 성공을 확인한 뒤 처리 위치를 기록합니다. DB 반영 후 기록 전에 죽을 수 있으므로 재실행 안전성도 필요합니다.
- 완료 검증: 읽은 수와 실제 매칭 수, 잔여 대상, 실패 항목을 확인합니다. 프로세스가 종료 코드 0으로 끝난 것만으로 데이터 정합성을 대신할 수 없습니다.
다음 실험에서는 같은 데이터·인덱스와 부하 조건에서 배치 크기만 바꾸고, 처리 시간·메모리 RSS·온라인 요청 p95·DB 상태를 함께 보겠습니다. 빈 컬렉션, 배치 크기보다 작은 데이터, 나누어떨어지지 않는 건수, 중간 실패 후 재실행도 확인 대상입니다.
당시에는 Take3과 Take4 중 어떤 것이 좋을지 고민했습니다. 지금의 결론은 좀 더 구체적입니다. 커서로 읽기와 제한된 bulk 쓰기를 조합하고, 완료 시간과 서비스 영향, 재실행 가능성을 함께 측정하자. CPU가 낮거나 실행이 빠르다는 한 가지 수치만으로 좋은 배치가 결정되지는 않겠습니다.